Von einem Container zu Kubernetes: Modelle für echte
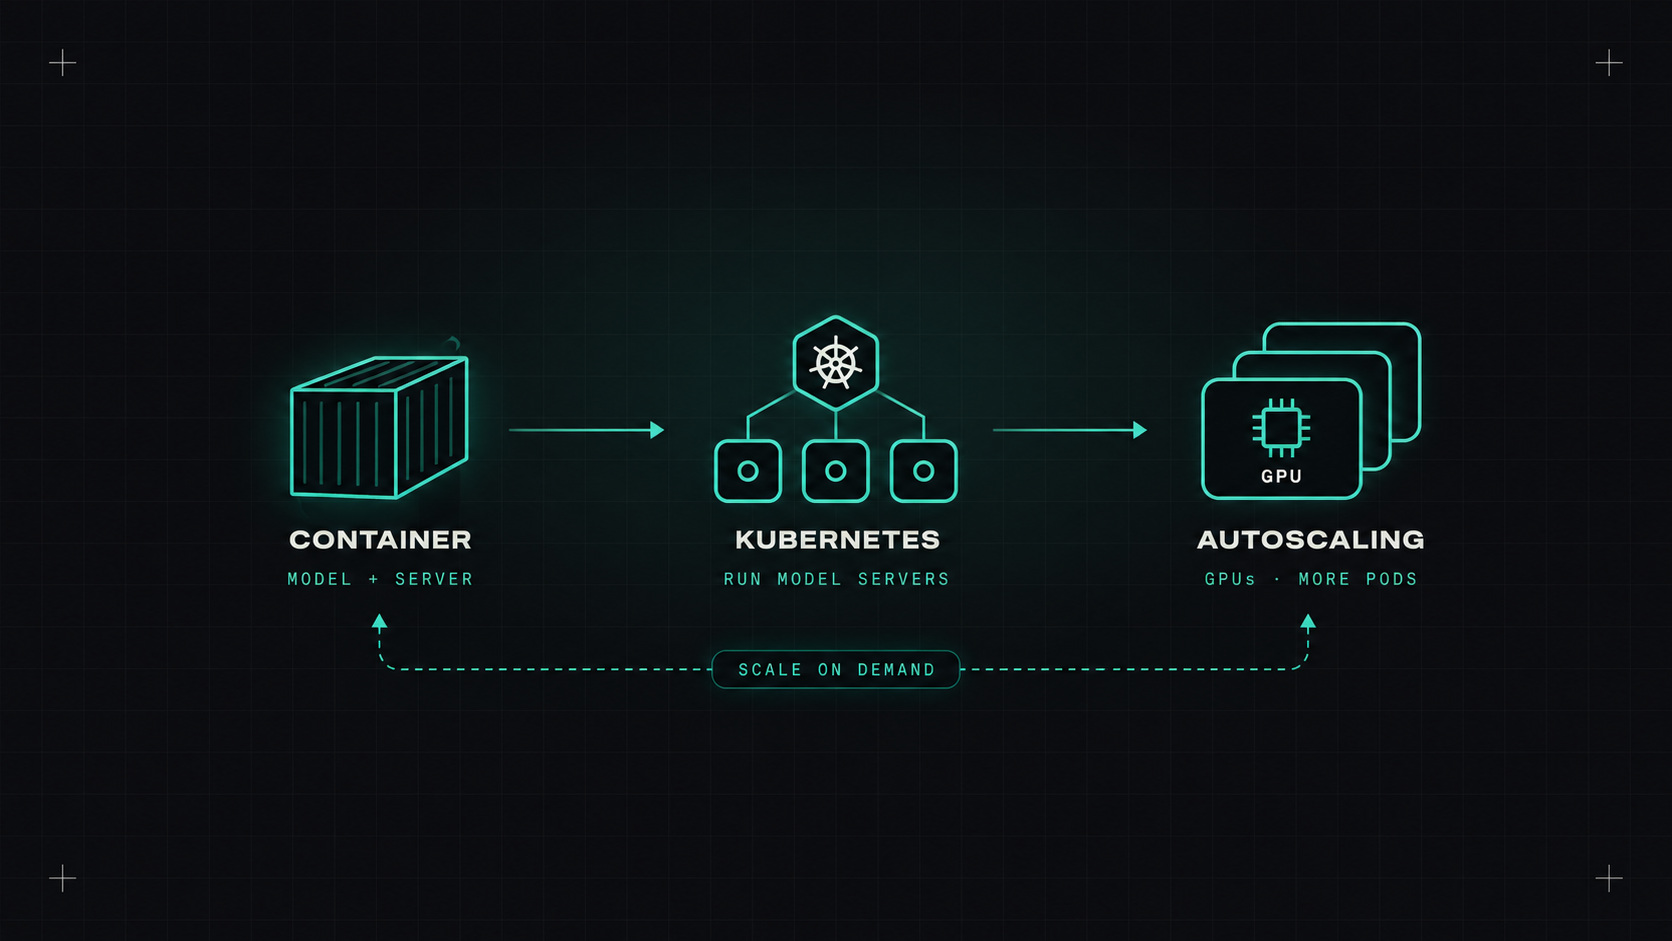
Der nächste Schritt in meiner MLOps-Reise: Modelle auf Kubernetes laufen lassen, mit GPUs und Autoscaling.
Der nächste Schritt in meiner MLOps-Reise: Modelle auf Kubernetes laufen lassen, mit GPUs und Autoscaling.
In KI & MLOps von Grund aufIch beschrieb meinen 24-Wochen-Plan: ein Notebook, dann ein getestetes Paket, eine verfolgte Pipeline, eine API mit FastAPI, einen Container und schließlich eine Bereitstellung in der Cloud mit Überwachung.
Ein Container ist ein großer Meilenstein. Aber ein einzelner Container auf einem Laptop ist nicht wie Modelle in Produktion laufen. Dieser Beitrag betrachtet den nächsten Schritt: Was ändert sich, wenn Sie das Modell auf Kubernetes verschieben und was anders ist, wenn das Modell ein großes Sprachmodell ist, das GPUs benötigt.
Das Kernprojekt des Plans ist ein klassisches Modell für maschinelles Lernen: scikit-learn, bedient von FastAPI, verpackt mit Docker. Für diese Art von Modell ist die Bereitstellung von Kubernetes nahe jedem anderen Webdienst. Ein Deployment, ein Service, Gesundheitsprüfungen, Ressourcenanfragen und ein HorizontalPodAutoscaler.
LLM ist eine andere Welt. Die Modelldateien sind Gigabyte groß, sie brauchen GPUs, sie laden langsam und eine Anfrage kann Sekunden dauern. Das ist, wo die interessanten DevOps Probleme sind.
Ein einzelner Behälter kann nicht:
Kubernetes kümmert sich um all das. Das Modell wird zu einer weiteren Arbeitsbelastung, mit denselben Leitungen, Überwachung und Sicherheit wie alles andere.
Der Servierstapel für LLMs auf Kubernetes hat in der Regel zwei Schichten.
Die Schlussfolgerungsmaschine Das Modell läuft tatsächlich:
Die Servierplattform verwaltet die Engine auf Kubernetes:
InferenceService Ressource: Sie beschreiben das Modell und die Laufzeit, und es behandelt Bereitstellung, Skalierung und Routing, einschließlich Skalierung bis Null.Eine minimale VLLM-Bereitstellung sieht so aus:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: llm
spec:
  replicas: 1
  selector:
    matchLabels: { app: llm }
  template:
    metadata:
      labels: { app: llm }
    spec:
      containers:
      - name: vllm
        image: vllm/vllm-openai:latest   # pin a specific version in real use
        args: ["--model", "Qwen/Qwen2.5-1.5B-Instruct"]
        ports:
        - containerPort: 8000
        resources:
          limits:
            nvidia.com/gpu: 1
        readinessProbe:
          httpGet: { path: /health, port: 8000 }
          initialDelaySeconds: 60
Einem Model zu dienen, ist die einfache Demo. Die MLOps müssen es zuverlässig, kostengünstig und in großem Maßstab bedienen.
GPUs verändern die Ausführung von Kubernetes:
nvidia.com/gpu.Und Kosten: Ein untätiges GPU-Knoten kann mehr pro Tag kosten als eine ganze kleine Webanwendung pro Monat. Die Überwachung der GPU-Nutzung (der DCGM-Exporteur für Prometheus) ist nicht optional.
CPU-basierte Autoskalierung funktioniert nicht gut für LLMs. Eine GPU kann vollständig beschäftigt sein, während die CPU inaktiv ist. Bessere Signale:
Auch planen Langsamer Start- Ich weiß . Das Herunterladen und Laden eines Modells kann Minuten dauern. Das Caching von Modelldateien auf einem persistenten Volume oder Knotenlokalspeicher und die Aufbewahrung von mindestens einer warmen Replik macht das Skalieren viel schmerzfreier.
Als nächstes auf meiner Liste: Überwachung des Modells in Produktion, einschließlich der Qualität seiner Antworten, nicht nur seiner Betriebszeit. Da kommen Werkzeuge wie Prometheus, Grafana und Evidently ins Spiel.
Meine Meinung: Kubernetes macht KI nicht einfach, aber es lässt KI-Workloads wie den Rest Ihrer Infrastruktur aussehen. Und das ist die halbe Schlacht.
Desly