Skalierung auf Kubernetes: HPA, VPA, KEDA und Karpenter
Vier Autoscaler, jeder mit seinem eigenen Job. Wann welche benutzen und wie sie zusammenarbeiten.
Vier Autoscaler, jeder mit seinem eigenen Job. Wann welche benutzen und wie sie zusammenarbeiten.
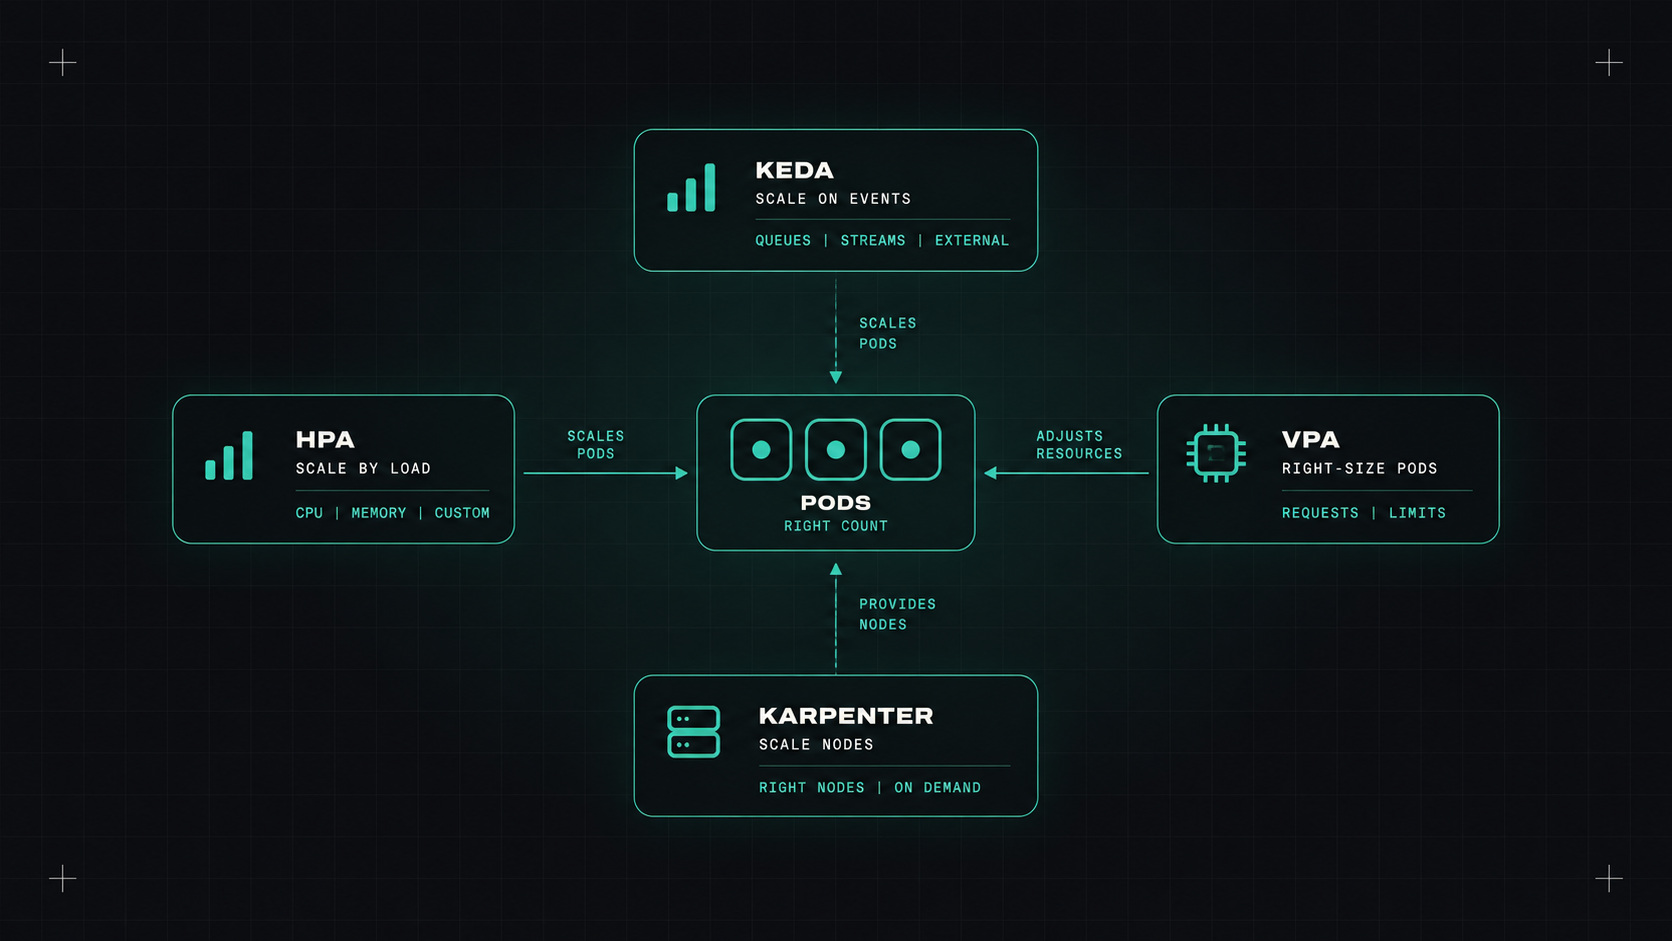
"Kubernetes skaliert automatisch" ist einer dieser Sätze, der zugleich wahr und irreführend ist. Kubernetes kann automatisch skaliert werden, aber nur, wenn man es einstellt, und es gibt mehrere verschiedene Autoscaler, die sehr unterschiedliche Dinge tun.
Ich erkläre sie Ihnen wie, und wie sie zusammenpassen.
Das erste, was man verstehen muss: Es gibt zwei Ebenen der Skalierung.
Normalerweise braucht man beides. Der Autoscaler erzeugt Kapseln, aber wenn es keinen Platz für sie gibt, bleiben sie. Pending bis ein Knoten-Autoscaler Kapazität hinzufügt.
Die Horizontale Pod Autoscaler ist in Kubernetes eingebaut. Es beobachtet eine Metrik und ändert die Anzahl der Repliken.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: shop-api
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: shop-api
  minReplicas: 2
  maxReplicas: 20
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
CPU-basierte Skalierung funktioniert gut für staatenlose Webdienste. Zwei Dinge zu wissen:
Die Vertikaler Pod Autoscaler Die Kommission hat die Kommission aufgefordert, die erforderlichen Maßnahmen zu ergreifen, um die
Es ist sehr nützlich in EmpfehlungsmodusWir lassen es eine Woche lang laufen und es sagt Ihnen, was Ihre Kapseln wirklich brauchen. Im automatischen Modus musste sie die Kapseln historisch neu starten, um ihre Ressourcen zu wechseln. Mit der vor Ort befindlichen Kapselgröße, die jetzt in Kubernetes stabil ist, wird das viel weniger störend.
Wichtig: Verwenden Sie nicht VPA und HPA auf der gleichen CPU-Metrik für die gleiche Arbeitsbelastung. Sie werden sich bekämpfen.
KEDA (Kubernetes Event-Driven Autoscaling) ist ein CNCF-Projekt, das HPA mit Dutzenden von Ereignisquellen erweitert: Warteschlange in RabbitMQ, Kafka-Verzögerung, SQS-Nachrichten, Prometheus-Abfragen, Cron-Zeitpläne und vieles mehr.
Seine tödliche Eigenschaft: Skalierung auf Null- Ich weiß . Ein Arbeiter, der eine Warteschlange verarbeitet, kann null Pods haben, wenn die Warteschlangen leer sind, und skalieren, wenn Nachrichten ankommen.
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: order-worker
spec:
  scaleTargetRef:
    name: order-worker
  minReplicaCount: 0
  maxReplicaCount: 30
  triggers:
  - type: rabbitmq
    metadata:
      queueName: orders
      mode: QueueLength
      value: "20"
    authenticationRef:
      name: rabbitmq-auth
Für Hintergrundarbeiter ist KEDA fast immer besser geeignet als CPU-basierte HPA. Die CPU sagt Ihnen, wie beschäftigt die Arbeiter sind. Die Warteschlange zeigt, wie viel Arbeit wartet.
Skalieren Sie auf das Signal, das die Arbeit darstellt, nicht die Nebenwirkung, die es zu machen bedeutet.
Für Knoten gibt es zwei Hauptoptionen.
Cluster-Autoskalierer ist der Klassiker. Es funktioniert mit Vordeterminationen. Wenn die Kapseln warten, fügt er einen Knoten zu einer passenden Gruppe hinzu. Wenn Knoten unterbenutzt sind, entfernt es sie. Zuverlässig, fast überall unterstützt.
Schreiner Das Projekt wurde von AWS gegründet und ist jetzt ein Kubernetes SIG-Projekt mit Unterstützung für AWS und Azure. Anstatt feststehende Knotengruppen betrachtet es die ausstehenden Pods und wählt den besten Instanztyp für sie vor Ort aus. Es ist schneller, oft billiger und gut darin, Konsolidierung: die Kapseln herum bewegen, damit sie unterbenutzte Knoten entfernen oder durch billigere ersetzen können. Es verarbeitet auch Spot-Instanzen gut.
Auf AWS würde ich Karpenter heute wählen. An anderer Stelle verwenden Sie das, was Ihr Anbieter am besten unterstützt, oft ihren verwalteten Autoscaler.
Autoscaling kann schwanken: aufs Neue skalieren, wieder nach unten skalieren, noch einmal skalieren. Möglichkeiten, es zu beruhigen:
behavior Die Kommission hat die Kommission aufgefordert, die in den letzten Jahren durchgeführten Untersuchungen zu überprüfen.Ein Setup, das mir für einen typischen Cluster gefällt:
Mein Verständnis: Autoscaling ist ein Teamsport. Erst die richtigen Anfragen, dann wählen Sie das richtige Signal für jede Arbeitsbelastung aus und lassen Sie den Autoscaler den Rest erledigen.
Desly