ഒരു കണ്ടെയ്നറിൽ നിന്ന് കുബർനെറ്റിലേക്ക്: യഥാർത്ഥ മോഡലുകൾ
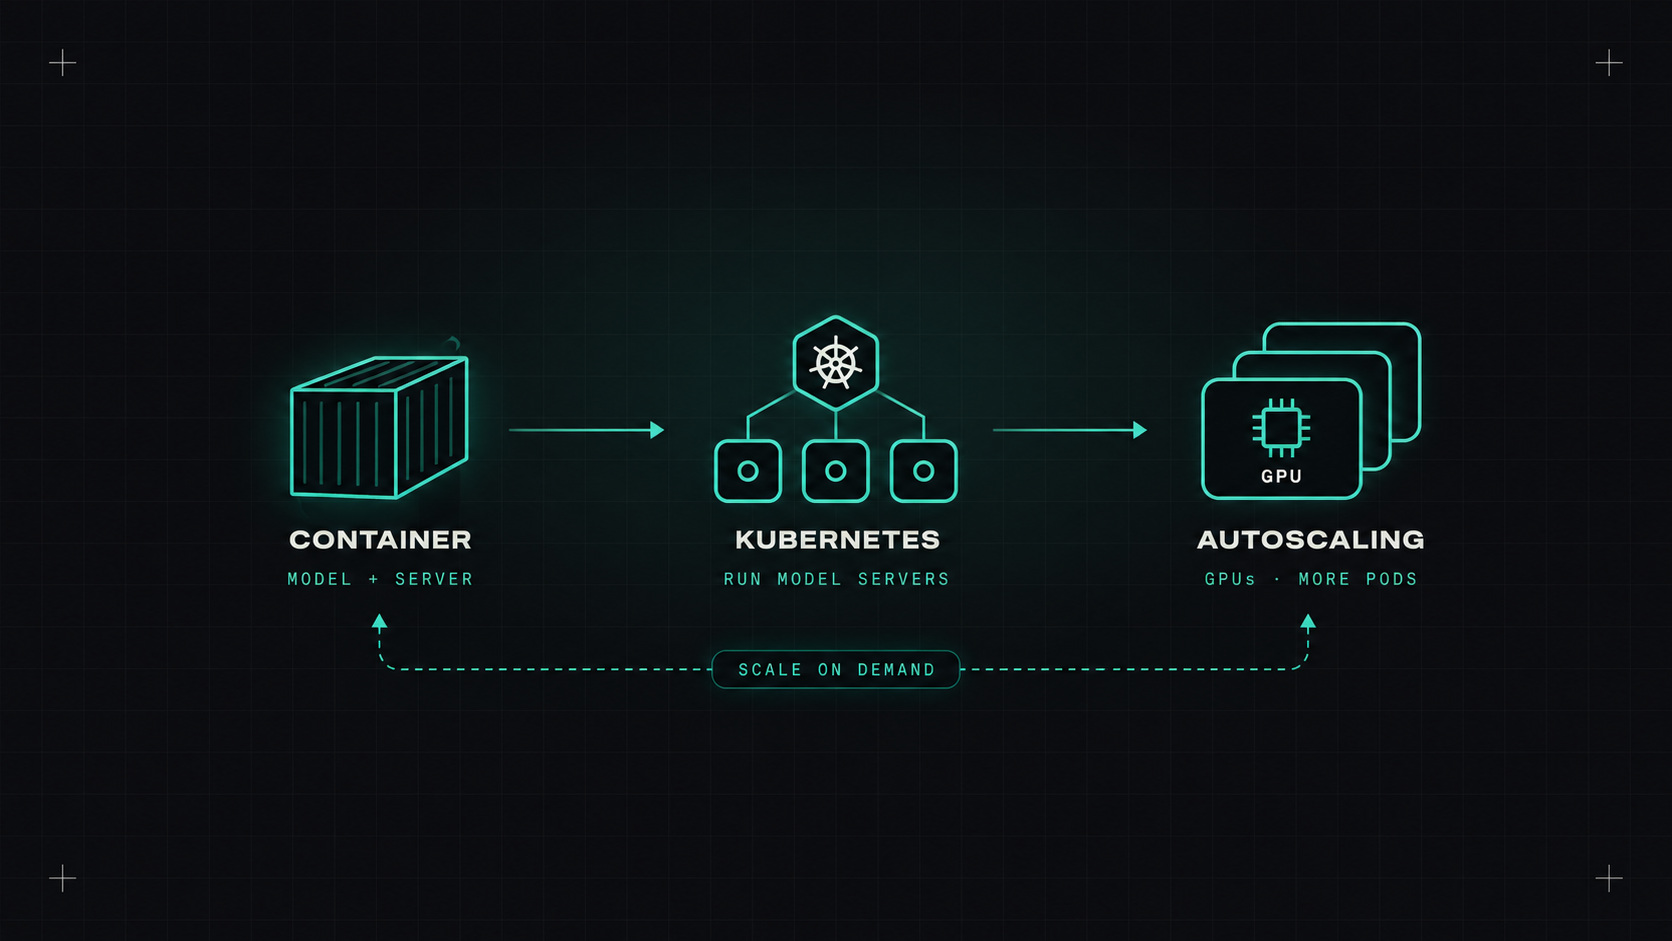
എന്റെ MLOps യാത്രയിലെ അടുത്ത ഘട്ടം: Kubernetes-ൽ മോഡലുകൾ പ്രവർത്തിപ്പിക്കുക, ജിപിയു, ഓട്ടോ സ്കെയിലിംഗ് എന്നിവ ഉപയോഗിച്ച്.
എന്റെ MLOps യാത്രയിലെ അടുത്ത ഘട്ടം: Kubernetes-ൽ മോഡലുകൾ പ്രവർത്തിപ്പിക്കുക, ജിപിയു, ഓട്ടോ സ്കെയിലിംഗ് എന്നിവ ഉപയോഗിച്ച്.
അകത്ത് AI-യും MLOps-ഉം, അടിത്തറ മുതൽ, ഞാൻ എന്റെ 24 ആഴ്ചത്തെ പ്ലാൻ വിവരിച്ചു: ഒരു നോട്ട്ബുക്ക്, പിന്നെ ഒരു പരീക്ഷിച്ച പാക്കേജ്, ഒരു ട്രാക്കുചെയ്ത പൈപ്പ്ലൈൻ, ഫാസ്റ്റ്എപിഐ ഉള്ള ഒരു എപിഐ, ഒരു കണ്ടെയ്നർ, ഒടുവിൽ നിരീക്ഷണമുള്ള ഒരു ക്ലൌഡിൽ വിന്യസിക്കൽ.
ഒരു കണ്ടെയ്നര് ഒരു വലിയ നാഴികക്കല്ലാണ്. പക്ഷെ ഒരു ലാപ്ടോപ്പിലെ ഒരു കണ്ടെയ്നര് , മോഡലുകള് ഉല്പാദനത്തില് ഓടുന്ന രീതി അല്ല. ഈ പോസ്റ്റ് അടുത്ത ഘട്ടം നോക്കുന്നുഃ നിങ്ങൾ മോഡൽ സേവനം കുബർനെറ്റസ് നീക്കുമ്പോൾ മാറ്റങ്ങൾ എന്താണ്, മോഡൽ ഒരു വലിയ ഭാഷ മോഡൽ ആണ് GPUs ആവശ്യമാണ് എന്തു വ്യത്യസ്തമാണ്.
ഈ പദ്ധതിയുടെ പ്രധാന പദ്ധതി ഒരു ക്ലാസിക് മെഷീൻ ലേണിംഗ് മോഡലാണ്: സ്കിറ്റി-ലേണിംഗ്, ഫാസ്റ്റ് എപിഐ ഉപയോഗിച്ച് സേവനം ചെയ്യുന്നു, ഡോക്കറുമായി പാക്കേജുചെയ്തിരിക്കുന്നു. അത്തരം മാതൃകയില് കുബർനെറ്റിസ് വിന്യാസം മറ്റേതൊരു വെബ് സേവനത്തിനും അടുത്ത് വരും. ഒരു വിന്യാസം, ഒരു സേവനം, ആരോഗ്യ പരിശോധനകൾ, വിഭവ അഭ്യർത്ഥനകൾ, ഒരു ഹൊറിസൊണ്ടൽപോഡ് ഓട്ടോസ്കേലര്.
എൽ. എൽ. എം. ഒരു വ്യത്യസ്ത ലോകമാണ്. മോഡൽ ഫയലുകൾ ജിഗാബൈറ്റ് വലുപ്പമുള്ളവയാണ്, അവയ്ക്ക് ജിപിയു വേണം, അവ വളരെ പതുക്കെ ലോഡ് ചെയ്യുന്നു, ഒരു അഭ്യർത്ഥനയ്ക്ക് നിമിഷങ്ങൾ എടുത്തേക്കാം. അവിടെയാണ് രസകരമായ DevOps പ്രശ്നങ്ങൾ.
ഒരു കണ്ടെയ്നറിന് കഴിയില്ല:
കുബർനെറ്റസ് എല്ലാം കൈകാര്യം ചെയ്യുന്നു. മോഡല് മറ്റൊരു വർക്ക് ലോഡായി മാറുന്നു, മറ്റെല്ലാ കാര്യങ്ങളും പോലെ തന്നെ പൈപ്പ്ലൈനുകളും നിരീക്ഷണവും സുരക്ഷയും ഉപയോഗിച്ച്.
കുബർനെറ്റിലെ LLM- കൾക്ക് സാധാരണയായി രണ്ട് പാളികളുണ്ട്.
നിഗമന യന്ത്രം യഥാർത്ഥത്തില് മോഡല് ഓടിക്കുന്നു:
സേവനം നല് കുന്ന പ്ലാറ്റ്ഫോം കുബർനെറ്റിലെ എഞ്ചിൻ നിയന്ത്രിക്കുന്നു:
InferenceService റിസോഴ്സ്: മോഡലും റൺടൈമും വിവരിക്കുക, അത് വിന്യാസം, സ്കെയിലിംഗ്, റൂട്ടിംഗ് എന്നിവ കൈകാര്യം ചെയ്യുന്നു, പൂജ്യത്തിലേക്ക് സ്കെയിൽ ഉൾപ്പെടെ.ഒരു മിനിമം വിഎല്എല്എം വിന്യാസം ഇങ്ങനെ കാണപ്പെടുന്നുഃ
apiVersion: apps/v1
kind: Deployment
metadata:
  name: llm
spec:
  replicas: 1
  selector:
    matchLabels: { app: llm }
  template:
    metadata:
      labels: { app: llm }
    spec:
      containers:
      - name: vllm
        image: vllm/vllm-openai:latest   # pin a specific version in real use
        args: ["--model", "Qwen/Qwen2.5-1.5B-Instruct"]
        ports:
        - containerPort: 8000
        resources:
          limits:
            nvidia.com/gpu: 1
        readinessProbe:
          httpGet: { path: /health, port: 8000 }
          initialDelaySeconds: 60
മോഡലിനെ സേവിക്കുക എന്നത് എളുപ്പമുള്ള പ്രകടനമാണ്. അത് വിശ്വസനീയമായും വിലകുറഞ്ഞതും വലിയ തോതിലുള്ളതുമായി സേവിക്കുക എന്നതാണ് MLOps യുടെ യഥാർത്ഥ ജോലി.
കുബർനെറ്റ്സ് എങ്ങനെ പ്രവർത്തിപ്പിക്കാമെന്ന് ജിപിയു മാറ്റുന്നു:
nvidia.com/gpu.വിലയും: ഒരു ജിപിയു നോഡ് ഒരു ദിവസം ഒരു ചെറിയ വെബ് ആപ്ലിക്കേഷനെക്കാളും വിലകൂടിയതായിരിക്കും. ജി. പി. യു ഉപയോഗം നിരീക്ഷിക്കുക എന്നത് (പ്രൊമെഥിയസ് കമ്പനിയിലെ ഡിസിജിഎം കയറ്റുമതിക്കാരൻ) ഓപ്ഷണലല്ല.
സിപിയു അടിസ്ഥാനമാക്കിയുള്ള ഓട്ടോ സ്കെയിലിംഗ് എൽഎൽഎമ്മുകൾക്ക് നന്നായി പ്രവർത്തിക്കുന്നില്ല. സിപിയു നിഷ്ക്രിയമായിരിക്കുമ്പോള് ഒരു ജിപിയു പൂർണ്ണമായും തിരക്കിലായിരിക്കും. നല്ല സിഗ്നലുകൾ:
കൂടാതെ പദ്ധതി പതുക്കെ തുടങ്ങുന്നു. ഒരു മോഡല് ഡൌണ് ലോഡ് ചെയ്യാനും ലോഡ് ചെയ്യാനുമൊക്കെ മിനിറ്റ് എടുക്കും. മോഡൽ ഫയലുകൾ ഒരു സ്ഥിരമായ വോളിയം അല്ലെങ്കിൽ നോഡ് ലോക്കൽ സ്റ്റോറേജിൽ കാഷെ ചെയ്യുകയും കുറഞ്ഞത് ഒരു ചൂടുള്ള പകർപ്പ് സൂക്ഷിക്കുകയും ചെയ്യുന്നത് സ്കേലിംഗ് വളരെ വേദന കുറയ്ക്കുന്നു.
അടുത്തത് എന്റെ ലിസ്റ്റിൽ: ഉല്പാദനത്തിലെ മോഡലിനെ നിരീക്ഷിക്കുക, അതിന്റെ ഉത്തരങ്ങളുടെ ഗുണനിലവാരം ഉൾപ്പെടെ, അതിന്റെ പ്രവർത്തന സമയം മാത്രമല്ല. അവിടെയാണ് പ്രോമിതിയസ്, ഗ്രഫാന, തെളിവ് തുടങ്ങിയ ഉപകരണങ്ങൾ വരുന്നത്.
എന്റെ അഭിപ്രായം: കുബർനെറ്റസ് AIയെ ലളിതമാക്കുന്നില്ല, പക്ഷേ AI വർക്ക് ലോഡുകളെ നിങ്ങളുടെ ബാക്കി ഇൻഫ്രാസ്ട്രക്ചറുകളായി കാണുന്നു. അത് യുദ്ധത്തിന്റെ പകുതി മാത്രമാണ്.
ഡെസ്ലി