Server, die man nie patchen kann: Goldene Bilder mit Packer
Statt zu reparieren, sollten Sie Server ersetzen. Wie eine unveränderliche Infrastruktur funktioniert.
Statt zu reparieren, sollten Sie Server ersetzen. Wie eine unveränderliche Infrastruktur funktioniert.
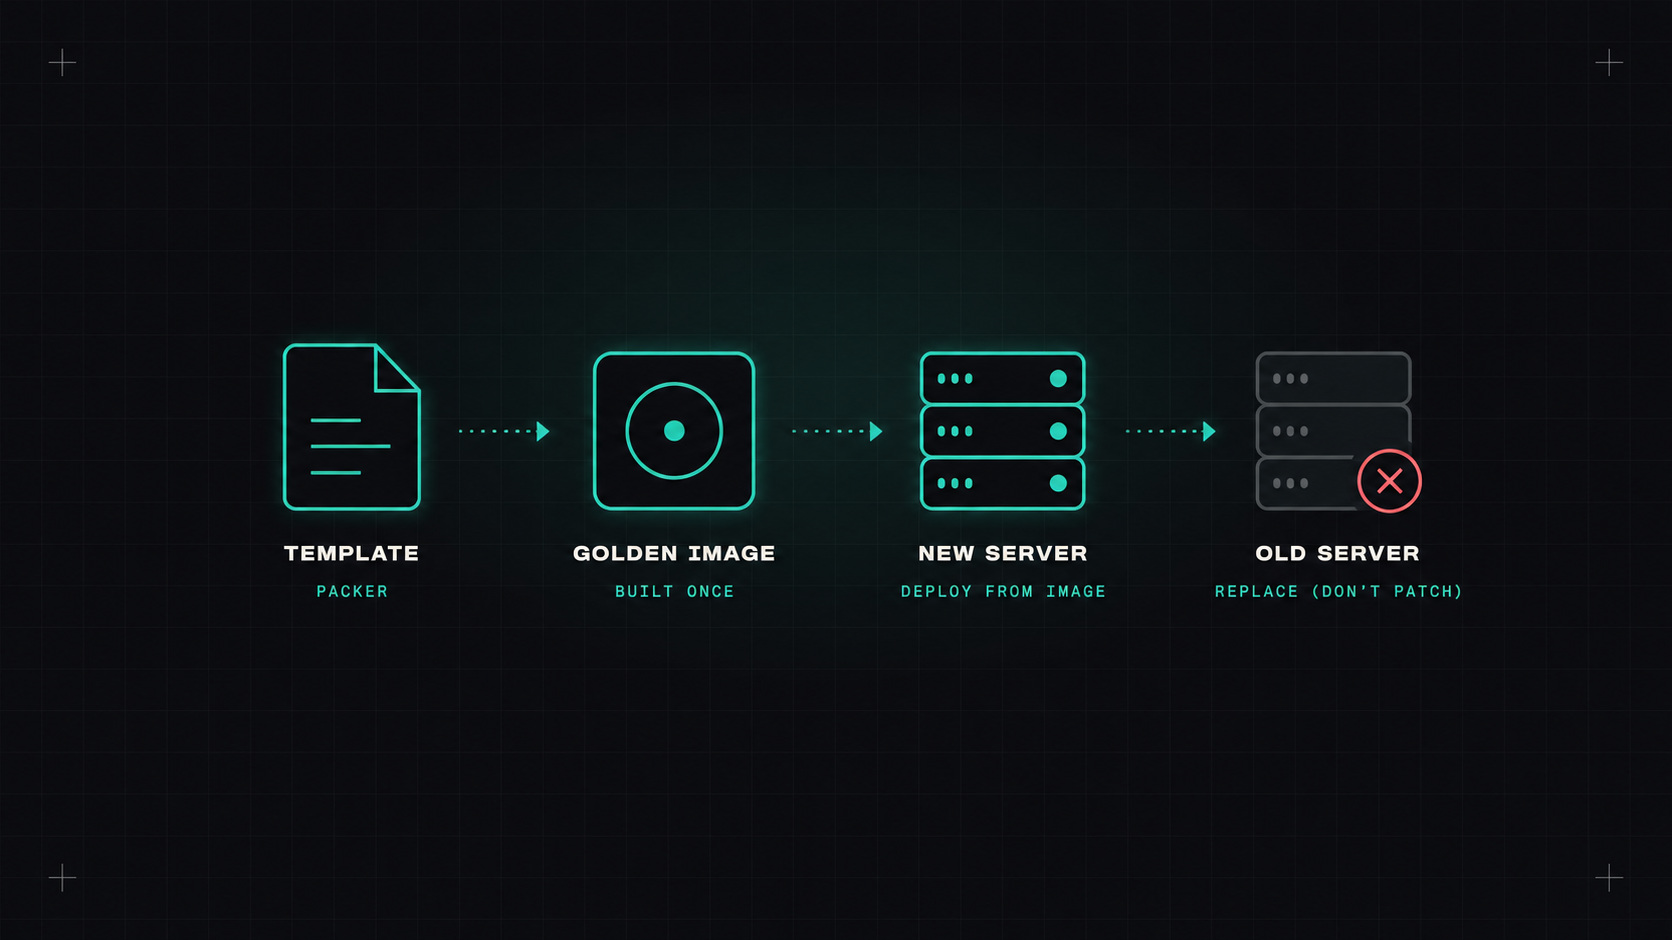
Es gibt eine alte Art, Server zu betreiben, mit der viele von uns aufgewachsen sind. Man baut eine Maschine auf, installiert die Software und hält sie dann jahrelang am Leben. Sie reparieren, schneiden, reparieren sie von Hand, wenn etwas kaputt geht. Im Laufe der Zeit wird jeder Server etwas anders, und niemand weiß genau, was auf ihnen ist. Die Leute nennen diese Server "Haustiere".
Man wechselt nie einen laufenden Server. Wenn sich etwas ändern muss, bauen Sie ein neues Bild, starten neue Server daraus und werfen die alten weg.
Die berühmte Analogie:
Die Container machten das Rindermodell für Anwendungen normal. Aber viele Workloads laufen immer noch auf virtuellen Maschinen: Kubernetes-Knoten selbst, Datenbanken, alte Apps, CI-Laufwerke, Appliances. Goldene Bilder bringen die gleiche Idee zu VMs.
Ein goldenes Bild ist ein vorgefertigtes Maschinenabbild (ein AMI auf AWS, ein verwaltetes Bild auf Azure, ein benutzerdefiniertes Bild auf Google Cloud, eine Vorlage auf VMware oder Proxmox), das bereits Folgendes enthält:
Ein neuer Server startet in Sekunden, bereits konfiguriert. Keine langen Setup-Skripte beim Booten, kein Drift zwischen den Maschinen.
Wenn ein Server repariert werden muss, repariere ihn nicht. Beheben Sie das Bild und ersetzen Sie den Server.
Packer, von HashiCorp, ist das gängigste Werkzeug für die Erstellung von Bildern. Sie beschreiben das Bild in HCL, und Packer startet eine temporäre Maschine, führt die Einrichtungsschritte aus und speichert das Ergebnis als Bild.
packer {
  required_plugins {
    amazon = {
      source  = "github.com/hashicorp/amazon"
      version = "~> 1.3"
    }
  }
}

source "amazon-ebs" "base" {
  region        = "eu-central-1"
  instance_type = "t3.small"
  ssh_username  = "ubuntu"
  ami_name      = "acme-base-{{timestamp}}"

  source_ami_filter {
    filters = {
      name                = "ubuntu/images/hvm-ssd-gp3/ubuntu-noble-24.04-amd64-server-*"
      virtualization-type = "hvm"
    }
    owners      = ["099720109477"] # Canonical
    most_recent = true
  }
}

build {
  sources = ["source.amazon-ebs.base"]

  provisioner "shell" {
    inline = [
      "sudo apt-get update",
      "sudo apt-get -y upgrade",
      "sudo apt-get -y install unattended-upgrades auditd"
    ]
  }

  provisioner "ansible" {
    playbook_file = "./playbooks/harden.yml"
  }
}
Die gleiche Vorlage kann Bilder für mehrere Wolken gleichzeitig erstellen. Provider können Shell-Skripte, Ansible-Playbooks oder andere Tools sein.
Bilder von Hand zu bauen, verhindert den Zweck. - Wir müssen es in eine Pipeline bringen.
Cloud-Anbieter bieten auch verwaltete Dienste an, wie EC2 Bildentwickler auf AWS und Azure VM-Bild-Ersteller.
Sicherheits-Patches werden ständig freigegeben. Bei unveränderlicher Infrastruktur bedeutet Patching, das Bild neu zu bauen und Server zu ersetzen.
Eine wöchentliche Neugestaltung hält die Bilder aktuell. Für kritische Schwachstellen, starten Sie sofort eine zusätzliche Build. Das Schöne an diesem Modell: Das Patchen ist die gleiche Routine wie jeder andere Wechsel, voll automatisiert und getestet, anstelle einer stressigen manuellen Patch-Nacht.
Goldene Bilder funktionieren am besten mit Autoscaling-Gruppen (oder VM-Skala-Sets oder verwalteten Instanzgruppen):
Kubernetes-Node-Pools funktionieren ähnlich: verwaltete Knotengruppen können mit einem rollenden Ersatz auf ein neues Bild aktualisiert werden. Werkzeuge wie Schreiner Sie gehen noch weiter und ersetzen die Knoten regelmäßig, um sie frisch zu halten.
Für jede Flotte von VMs, die Sie länger als ein paar Wochen betreiben, ja. Weniger Überraschungen, schnelleres Skalieren, einfacher zu patchen, und Sie wissen immer genau, was läuft.
Ich sage: Hör auf, Server zu pflegen. Baue sie einmal richtig, ersetze sie oft und lass das Bild das Wissen tragen.
Desly