Schnellere CI-Pipelines: von 40 Minuten bis 8 Minuten
Die Caching- und Split-Tricks, die den größten Unterschied machen.
Die Caching- und Split-Tricks, die den größten Unterschied machen.
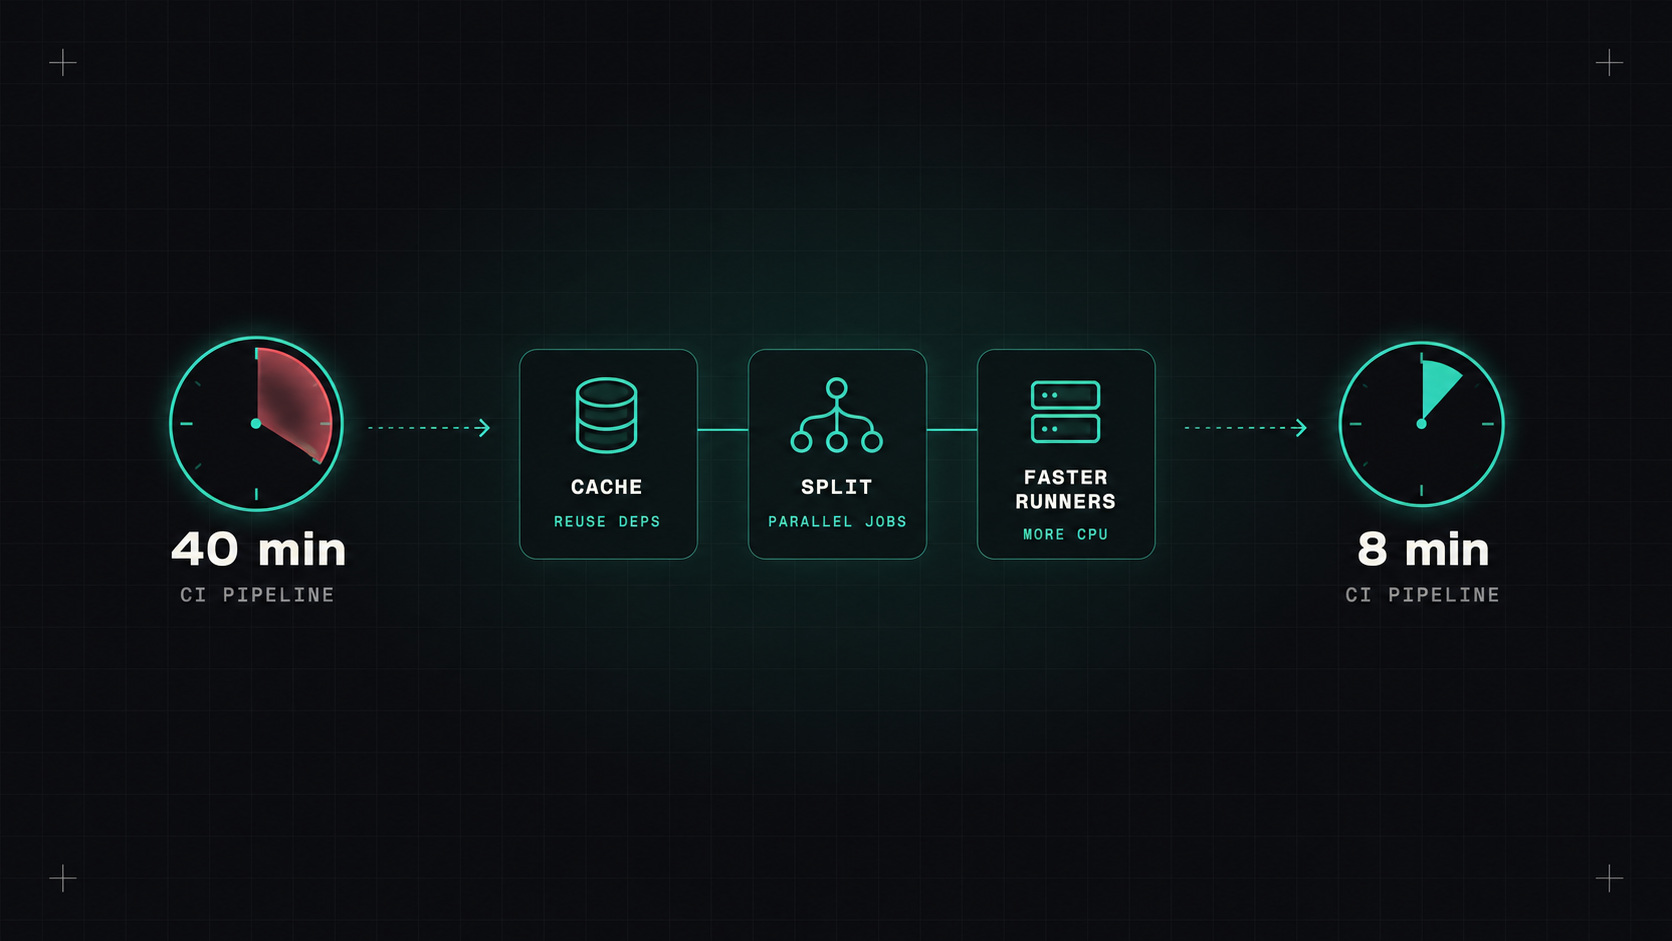
Eine langsame Pipeline kostet mehr als Rechenzeit. Entwickler wechseln während des Warten zu etwas anderem, verlieren den Fokus, stapeln Änderungen, um nicht wieder zu warten, und beginnen sich mit "es wird wahrscheinlich vorbei gehen" zu verschmelzen. Eine 40-minütige Pipeline macht alles ruhig schlimmer: größere Änderungen, langsamere Überprüfungen, mehr Risiko.
Die meisten Projekte können ihre Pipeline-Zeit von etwa vierzig Minuten auf weniger als zehn Minuten verkürzen. Hier sind die Techniken, die den größten Unterschied machen, in der Reihenfolge, in der ich sie ausprobieren würde.
Optimieren Sie nicht blind. Erstens:
Normalerweise dauert es die meiste Zeit drei oder vier Schritte. Konzentriere dich dort.
Der größte Gewinn für die meisten Pipelines.
Abhängigkeits-Cache. Paket-Downloads (npm, pip, Maven, Go-Module) sollten nicht bei jedem Lauf von Grund auf neu erfolgen. Die meisten Setup-Aktionen haben eine eingebaute Cache-Option, die in der Schließdatei eingegeben ist:
- uses: actions/setup-node@<sha> # v4
  with:
    node-version: 22
    cache: npm
Caching der Docker-Schicht. Mit BuildKit, Cache-Schichten zwischen Ausführungen, im Cache des CI-Anbieters oder in einer Registrierung:
- uses: docker/build-push-action@<sha> # v6
  with:
    cache-from: type=registry,ref=ghcr.io/my-org/shop-api:buildcache
    cache-to: type=registry,ref=ghcr.io/my-org/shop-api:buildcache,mode=max
In Kombination mit einer gut geordneten Dockerfile (Dependenzen zuerst, Code zuletzt) fallen Bildbauten oft von vielen Minuten auf gut unter einen.
Bauen Sie Cache. Tools wie Gradle, Bazel, Nx und Turborepo können Builds speichern und Test-Ausgänge aus der Ferne durchführen, so dass unveränderte Module überhaupt nicht neu aufgebaut oder erneut getestet werden.
Die schnellste Arbeit ist die Arbeit, die Ihre Pipeline nicht wieder tun muss.
Viele Rohrleitungen laufen aus Gewohnheit aus Schritte nach Schritt. Suchen Sie nach selbständiger Arbeit:
Tests sind oft der längste Schritt. Zwei Techniken:
Testspaltung. Teilen Sie die Testsuite auf mehrere parallele Aufgaben auf, idealerweise basierend auf historischem Timing, so dass jeder Job ungefähr die gleiche Zeit in Anspruch nimmt. Viele Test-Frameworks und CI-Tools unterstützen dies entweder nativ oder mit kleinen Hilfswerkzeugen.
Flakey-Test-Quarantäne. Ein Versuch, der fehlschlägt, zwingt zufällig, die ganze Pipeline zu wiederholen. Das ist reiner Abfall. Verfolgen Sie schlaffe Tests, verschieben Sie sie zu einem separaten nicht-blockenden Job und beheben Sie sie mit einer Frist. Man muss nie einfach automatische Wiederholungen hinzufügen und es vergessen.
Frag auch: Muss jeder Test auf jedem Commit ausgeführt werden? Lange End-to-End-Suiten können auf merge to main oder nightly ausgeführt werden, während Pull-Anfragen eine fokussierte Untermenge ausführen.
In Monorepos ist der größte Abfall, wenn man alles umbaut und erneut testet, um eine einseitige Veränderung zu erreichen:
Manchmal ist die Maschine der Engpass:
fetch-depth: 1Es sei denn, Sie brauchen eine Geschichte.concurrency mit cancel-in-progress).Unter zehn Minuten von einem Push bis zu einem grünen Check für eine Pull-Anfrage ist ein gutes Ziel für die meisten Dienste. Unter fünf ist fantastisch. Beginnen Sie mit Messungen, fügen Sie Caching hinzu, parallelisieren, behandeln Sie schmalen Tests, und Sie werden überrascht sein, wie viel Zeit verschwindet.
Meine Meinung: Die Pipeline-Geschwindigkeit als Merkmal. Jede Minute, die Sie sparen, wird von jedem Entwickler bei jedem Commit wieder gespeichert.
Desly