Kubernetes-Fehler, die ich jede Woche sehe, und wie ich sie behebe
CrashLoopBackOff, Bildrückzug, warten. Eine praktische Reparaturliste mit einem Cheat-Sheet.
CrashLoopBackOff, Bildrückzug, warten. Eine praktische Reparaturliste mit einem Cheat-Sheet.
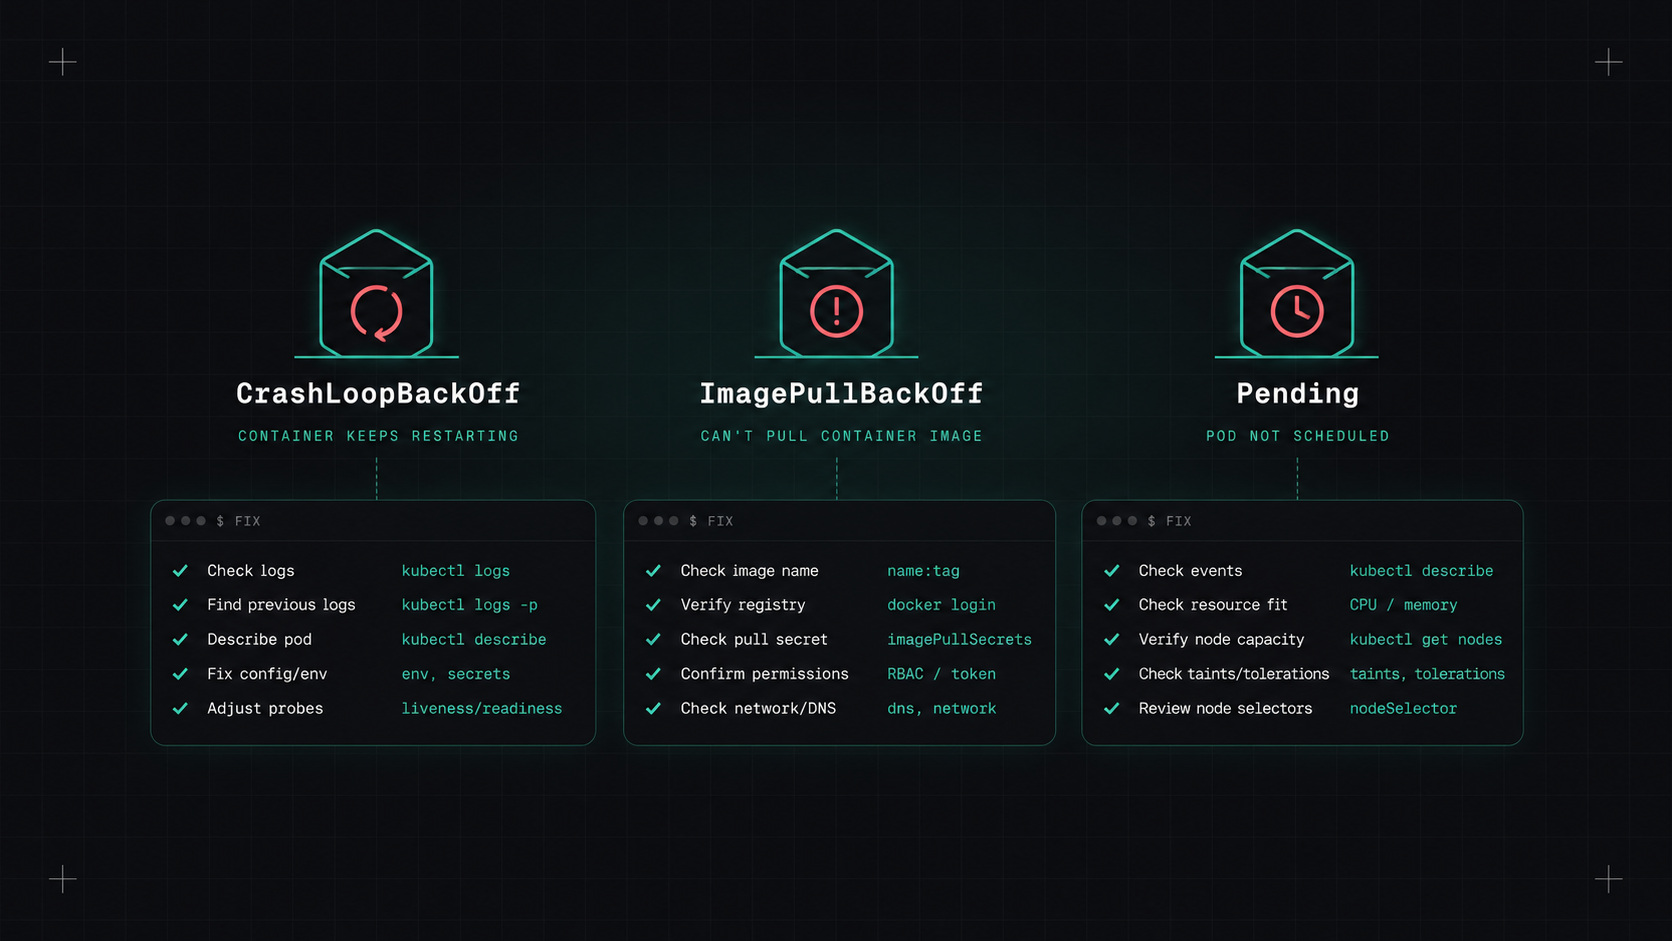
Die Fehlermeldungen von Kubernetes haben ein besonderes Talent: Sie sagen Ihnen, dass etwas nicht stimmt, in Großbuchstaben, ohne Ihnen zu sagen, warum. CrashLoopBackOff. ImagePullBackOff. Pending- Ich weiß . Wenn man mit Kubernetes arbeitet, sieht man das jede Woche.
Die gute Nachricht: Die gleichen wenigen Ursachen erklären die meisten dieser Fehler. Hier ist mein üblicher Debug-Prozess und die Korrekturen, die ich zuerst versuche.
Was auch immer der Fehler ist, ich beginne mit den gleichen drei Befehlen:
kubectl get pods -n shop                 # what state is it in?
kubectl describe pod <pod> -n shop       # events at the bottom tell the story
kubectl logs <pod> -n shop --previous    # logs from the crashed container
Die Ereignisse Abschnitt unten kubectl describe ist das am meisten unterschätzte Debugger-Tool in Kubernetes. Neun von zehn Mal ist die Antwort da.
Für das größere Bild:
kubectl get events -n shop --sort-by=.lastTimestamp
Der Container startet, abstürzt, Kubernetes startet ihn neu, er abstürzen wieder, und Kubernetes wartet immer länger zwischen den Versuchen.
Häufige Ursachen:
- Die Anwendung selbst versagt beim Starten: fehlende Konfiguration, falsche Umgebungsvariable, kann nicht zur Datenbank gelangen. - Ein fehlendes Geheimnis oder ein Konfigurationsschlüssel. - Die Lebenssonde tötet den Container, bevor er fertig ist. - Aus dem Speicher beim Starten (Siehe nach OOMKilled).
- Das ist nicht wahr . kubectl logs --previous zeigt, warum der letzte Lauf tot war. Wenn die Protokolle leer sind, ist der Prozess wahrscheinlich abgestürzt, bevor etwas protokolliert wurde: überprüfen Sie den Befehl, den Eingangspunkt und das Bild.
Kubernetes kann das Container-Bild nicht herunterladen.
Häufige Ursachen:
- Ein Tippfehler im Bildnamen oder Tag. - Das Tag existiert nicht (es wurde nie eingeschoben oder gelöscht). - Privatregister ohne imagePullSecret, oder eine abgelaufene. - Die Tarifbegrenzung. - Der Knoten kann nicht die Registrierung erreichen (Netzwerk, Proxy, Firewall).
- Das ist nicht wahr . Die Ereignismeldung sagt normalerweise genau, welche: "nicht gefunden", "nicht autorisiert" oder "zu vielen Anfragen".
Die Kapsel wurde erstellt, aber kein Knoten wird sie laufen lassen.
Häufige Ursachen: - Keine CPU oder Speicher für die Kapsel. Anträge- Ich weiß . - Knoten-Selektoren, Affinität-Regeln oder Flecken, die kein Knoten passt. - Eine PersistentVolumeClaim, die nicht gebunden werden kann (falsche StorageClass, falsche Zone). - Der Autoscaler hat noch keinen Knoten hinzugefügt.
- Das ist nicht wahr . kubectl describe pod zeigt eine Meldung wie "0/5 Knoten verfügbar: 3 unzureichender Speicher, 2 Knoten hatten nicht tolerierten Schadstoff". Das sagt dir genau, was du ändern musst.
Der Container verbrauchte mehr Speicher als er hatte und wurde getötet. Ausfahrtcode 137.
- Das ist nicht wahr . Überprüfen Sie die tatsächliche Speicherverwendung, dann erhöhen Sie entweder das Limit oder beheben Sie das Leck. Stellen Sie sicher, dass die Sprache Runtime über den Speicherlimit des Containers weiß.
Der Knoten hatte wenig Speicher und Diskette und entfernte die Kapseln, um sich zu schützen.
- Das ist nicht wahr . Setzen Sie die richtigen Speicheranfragen, überprüfen Sie, ob es keine Pods gibt, die große Protokolle oder temporäre Dateien schreiben, und schauen Sie sich die Nutzung der Knotenplatte an. Sie räumen alte Räumungskörper mit kubectl delete pod --field-selector=status.phase=Failed.
Normalerweise existiert kein verwiesenes Secret oder ConfigMap (oder ein Schlüssel darin). Das Ereignis nennt es.
Der Container läuft, aber Kubernetes sendet keinen Traffic.
- Das ist nicht wahr . Überprüfen Sie den Probeweg und den Hafen und testen Sie ihn von innen. Stellen Sie sicher, dass die Sonde nicht von externen Diensten abhängt, die langsam sein könnten.
Kubernetes sagt dir fast immer, was nicht stimmt. Es stellt einfach die Antwort am Ende der
kubectl describe.
"Es funktioniert in der Kapsel, aber nicht über den Service" ist eine eigene Kategorie.
# Does the Service have endpoints?
kubectl get endpointslices -n shop -l kubernetes.io/service-name=shop-api

# Test from inside the cluster
kubectl run tmp --rm -it --image=busybox:1.36 -- sh
# then: wget -qO- http://shop-api.shop.svc.cluster.local:8080/health
Häufige Ursachen:
- Keine Endpunkte: der Service-Selektor passt nicht zu den Kapsel-Etiketten. Sehr häufig nach einer Umbenennung. - Ich weiß . Falscher Hafen: port gegen targetPort - Es war ein Durcheinander. - Ich weiß . Netzwerkrichtlinie - Der Verkehr wird blockiert. Wenn eine Richtlinie eine Kapsel auswählt, wird alles, was nicht ausdrücklich erlaubt ist, verweigert. - Ich weiß . DNS-Daten: überprüfen, ob CoreDNS-Pods aktiv sind, und verwenden Sie den vollständigen Dienstnamen in den Namensräumen.
kubectl debug Startet einen kurzlebigen Debug-Container in einer laufenden Kapsel, auch wenn das Bild keine Shell hat. Wesentlich für distroless Bilder.kubectl exec für Bilder, die eine Hülle haben.kubectl port-forward um einen Dienst von Ihrem Laptop aus zu testen.| Status | Das erste, was ich überprüfen muss. |
|---|---|
| - Das ist nicht wahr. | kubectl logs --previous |
| Bild zurückziehen | Ereignismeldung: Name, Tag, Anmeldeinformationen, Ratenbegrenzung |
| Ausstehend | describe Veranstaltungen: Ressourcen, Schadstoffe, PVC |
| - Er wurde getötet. | Speicherverbrauch vs. Grenze |
| Ausgestoßen | Knotenspeicher/Festplattendruck, fehlende Anfragen |
| ErstellenContainerConfigError | Vermisste Geheimnis-/KonfigMap- oder Schlüsselfunktion |
| Nicht bereit | Bereitschaftssondebahn, Hafen und Abhängigkeiten |
| Service nicht erreichbar | Endpunkte, Auswählungsetiketten, Ports, Netzwerkrichtlinie, DNS |
Meine Meinung: Lernen Sie, Ereignisse und vorherige Protokolle zu lesen, und die meisten Kubernetes-Geheimnisse lösen sich in Minuten.
Desly