Eine KI-App in Produktion beobachten
Als nächstes auf meiner MLOps-Reise: Spuren, Token, Kosten und Qualität.
Als nächstes auf meiner MLOps-Reise: Spuren, Token, Kosten und Qualität.
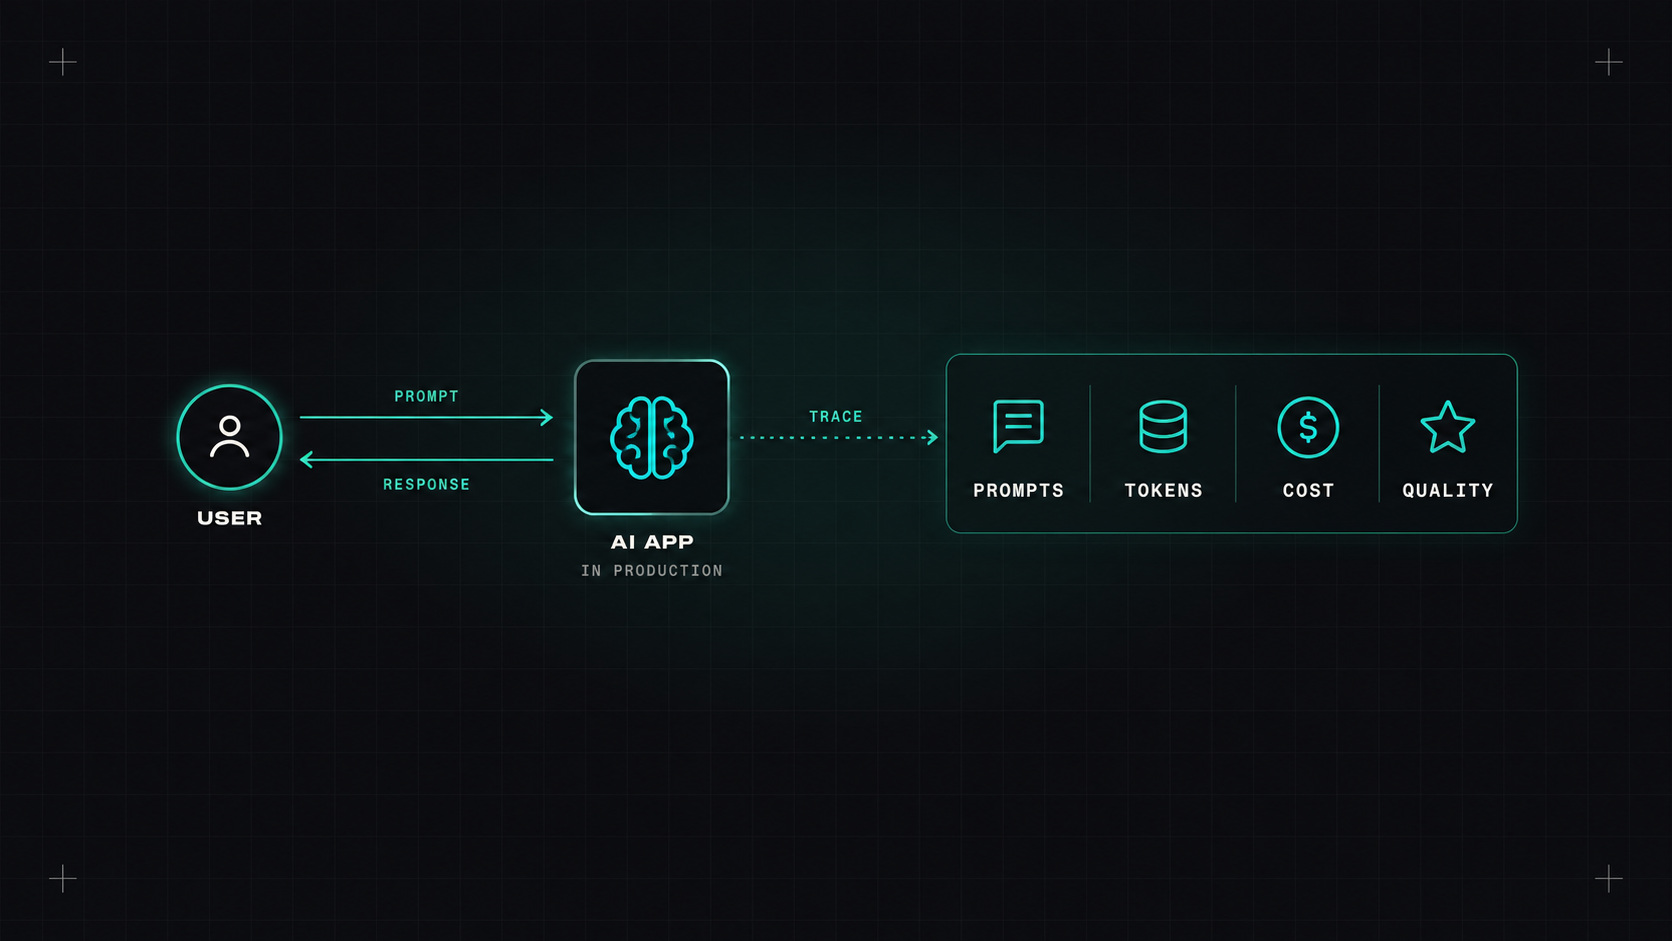
Ich ... Lernplan der MLO Wir haben die Daten über die Datenbank von Prometheus, Grafana und Evidently. Als ich diesen Plan schrieb, dachte ich daran, wie ich es in DevOps mache zu überwachen: ist es hoch, ist es schnell, ist es Fehler werfen?
Je mehr ich lerne, desto klarer wird, dass KI-Systeme eine zweite Schicht brauchen. Ein Modell kann schnell und fehlerfrei sein und trotzdem schreckliche Antworten geben. Dieser Beitrag geht darum, diese zweite Schicht zu beobachten.
Ich sehe es in drei Ebenen.
1. Die Die übliche Gesundheitslage. Alles, was wir bereits überwachen: Anforderungsrate, Fehlerrate, Latenzzeit, Ressourcennutzung. Ein KI-Dienst ist immer noch ein Dienst.
2. Die Modellspezifische Vorgänge. Für LLM-Anträge insbesondere:
3. Die Qualität. Das schwierige:
Bei normaler Software bedeutet "keine Fehler" dass sie funktioniert. Für KI bedeutet "keine Fehler" einfach, dass sie etwas selbstbewusst macht.
Eine einzige Anfrage an eine KI-Funktion kann viele Schritte beinhalten: Dokumenten abrufen, eine Aufforderung erstellen, ein Modell aufrufen, Tools aufrufen und das Modell erneut aufrufen. Wenn die Antwort falsch ist, musst du jeden Schritt sehen.
Genau das macht verteiltes Tracing. Jeder Schritt wird zu einer Spanne, mit den Eingaben, Ausgängen, Token, Kosten und Zeitplan. Wenn ein Benutzer sich beschwert, können Sie die Spur öffnen und sehen, dass zum Beispiel der Abrufschritt die falschen Dokumente zurückgegeben hat.
Die OpenTelemetry, die viele von uns bereits für normale Dienste nutzen, hat semantische Konventionen für die generierende KI: Standardattributnamen für Dinge wie das verwendete Modell, die Anzahl der Token und den Operationstyp. Bibliotheken wie OpenLLMetry automatische Instrumente für beliebte LLM-SDKs und -rahmenwerke hinzufügen.
Der Vorteil: KI-Spuren können in das gleiche Backend fließen wie der Rest Ihrer Spuren (Tempo, Jaeger, Datadog, Honeycomb und so weiter), so dass Sie den KI-Schritt innerhalb der vollständigen Benutzeranfrage sehen.
Eine wichtige Warnung: Aufforderungen und Antworten können Personenbezogene Daten- Ich weiß . Entscheiden Sie sorgfältig, was Sie aufnehmen, verbergen Sie sensible Felder und setzen Sie Aufbewahrungslimits.
Neben allgemeinen Beobachtungswerkzeugen gibt es eine Gruppe von Tools, die für LLM-Anwendungen entwickelt wurden:
Für mein Lernprojekt würde ich mit Evidently für das klassische Modell beginnen (es ist bereits im Plan) und Langfuse oder Phoenix versuchen, sobald ein LLM beteiligt ist.
Die Überwachung sagt Ihnen von Problemen, nachdem die Nutzer sie gesehen haben. Bewertungen Versuchen Sie, sie zu fangen.
Die Idee: eine Reihe von Testfragen mit guten Antworten. Jedes Mal, wenn Sie eine Anforderung, ein Modell oder die Abruflogik ändern, führen Sie den Satz aus und bewerten die Ergebnisse, automatisch oder mit einem anderen Modell als Richter. Wenn die Qualität sinkt, versagt die Pipeline, genau wie ein fehlgeschlagener Einheitstest.
Es ist nicht perfekt, weil "gute Antwort" verschwommen ist. Aber ein grundlegendes Auswertungs-Set fängt eine überraschende Anzahl von Regressionen auf, besonders wenn man von Modell wechselt.
Mit der Überwachung ist die Schleife vollständig: Bau, Test, Einsatz, Beobachtung, Verbesserung. Als nächstes möchte ich untersuchen, was zu tun ist, wenn die Überwachung eine Drift zeigt: Umschulung, Versionenüberarbeitung und sichere Einführung neuer Modellversionen.
Ich nehme an: Überwachen Sie die KI-Systeme zweimal. Einmal wie jeder Dienst, und einmal wie ein neuer Kollege, dessen Arbeit man noch überprüfen muss.
Desly