Es ist immer DNS.
Warum DNS so oft kaputt geht und wie man es weniger kaputt macht.
Warum DNS so oft kaputt geht und wie man es weniger kaputt macht.
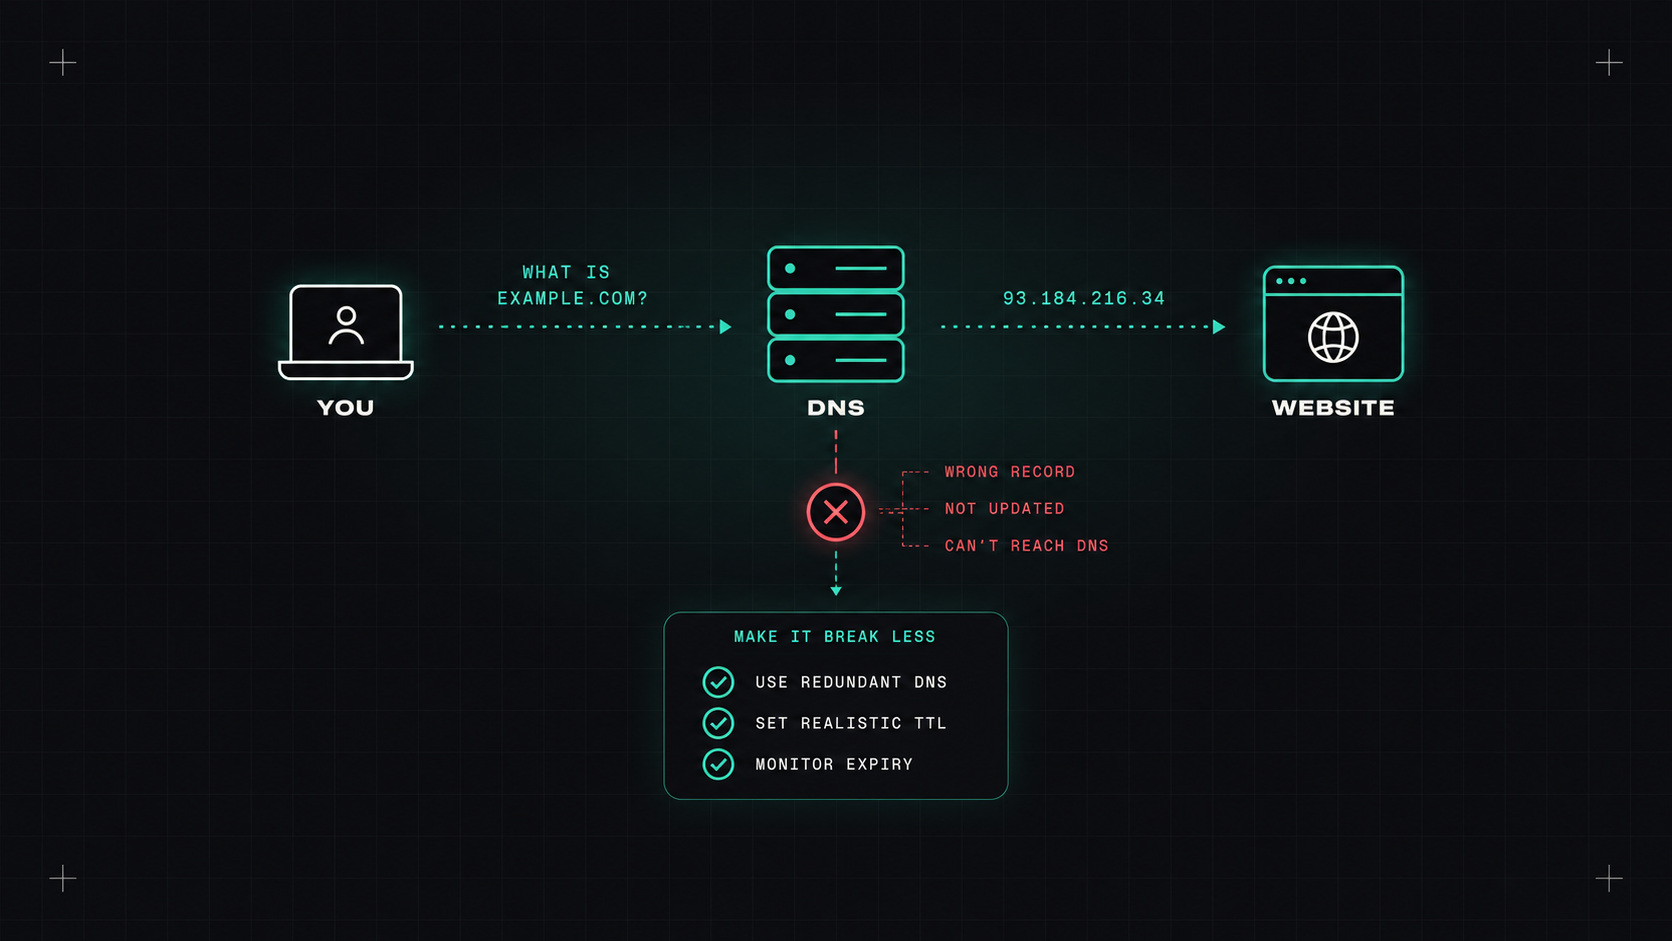
Es gibt ein berühmtes Haiku unter Systemadministratoren:
Es ist nicht DNS. Es ist unmöglich, dass es DNS ist. Es war DNS.
Es ist lustig, weil es wahr ist. Einige der größten Ausfälle der letzten Jahre bei Cloud-Anbietern und großen Websites waren DNS-Probleme. Und in der täglichen Arbeit endet ein großer Teil der "App kann nicht verbinden" Rätsel damit, dass jemand sagt: "Oh, es löst sich auf die alte Adresse".
Warum verursacht DNS so viele Probleme, und was können wir dagegen tun?
Fast jede Netzwerkverbindung beginnt mit einer DNS-Suche. Ihr Browser, Ihre App, die sich mit der Datenbank verbindet, eine Kapsel, die einen anderen Dienst anruft, ein Informantenjob, der ein Bild abruft. Wenn DNS langsam ist, ist alles langsam. Wenn es falsch ist, geht alles an den falschen Ort. Wenn es ausfällt, funktioniert nichts, auch wenn jeder Server gesund ist.
Und DNS ist auf vielen Ebenen zwischengespeichert: in Anwendungen, in Betriebssystemen, in lokalen Resolver, bei Ihrem ISP. Das bedeutet, dass Probleme inkonsistent, verzögert und sehr schwer zu reproduzieren sein können.
Die Platten, mit denen du am meisten arbeiten wirst:
example.comDie Anbieter bieten dafür ALIAS- oder ANAME-Datensätze an.)TTL (Zeit bis zum Leben) sagt den Resolver, wie lange sie eine Antwort speichern sollen. Es ist der wichtigste Hebel, den Sie haben:
Ein klassischer Fehler: eine Migration planen, den Datensatz ändern und die alte TTL 24 Stunden lang entdecken. Senken Sie die TTL ein oder zwei Tage vor eine geplante Änderung, dann sie später wieder aufwerfen.
DNS-Änderungen passieren nicht, wenn du sie machst. Sie passieren, wenn die letzte Schatzkammer der Welt die alte Antwort vergisst.
Kubernetes hat seine eigene DNS, normalerweise Kern-DNS- Ich weiß . Jeder Dienst hat einen Namen wie orders.shop.svc.cluster.local.
Ein paar Dinge, die Menschen aufstacheln:
orders Arbeiten aus dem shop Name-Space; aus anderen Stellen, Verwendung orders.shop oder den vollständigen Namen.ndots:5 Einstellung. Standardmäßig behandeln Pods Namen mit weniger als fünf Punkten als relativ und versuchen zunächst mehrere Suchdomains. Eine Suche nach api.example.com kann mehrere fehlgeschlagene Abfragen vor der echten erzeugen. Für externe Namen ein Punkt (api.example.com.) oder Stimmung ndots in der Kapsel dnsConfig reduziert das.Die manuelle Verwaltung öffentlicher DNS-Datensätze für jeden Dienst ist fehleranfällig. ExternalDNS überwacht Kubernetes-Ressourcen (Services, Ingresses, Gateway API Routes) und erstellt automatisch DNS-Datensätze in Route 53, Cloud DNS, Azure DNS, Cloudflare und vielen anderen.
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: shop
  namespace: shop
spec:
  parentRefs:
  - name: web
    namespace: infra
  hostnames: ["shop.example.com"]   # ExternalDNS creates this record
  rules:
  - backendRefs:
    - name: shop-api
      port: 8080
Sie werden mit einem TXT-Registrierung Also berührt es nur die Aufzeichnungen, die es besitzt, und ein Filter für die Domäne Also kann es keine Zonen modifizieren, die es nicht sollte.
DNS kann den Datenverkehr von Fehlern ablenken:
Denken Sie an die TTL: Failover kann nur so schnell sein, wie Caches ablaufen. Und einige Clients speichern DNS viel länger als das TTL sagt (ältere Java-Versionen waren dafür berühmt).
dig shop.example.com +short                 # what does my resolver say?
dig @1.1.1.1 shop.example.com +short        # what does a public resolver say?
dig shop.example.com +trace                 # follow it from the root
dig shop.example.com NS                     # who is authoritative?
kubectl run -it --rm dnstest --image=busybox:1.36 -- nslookup orders.shop   # from inside the cluster
Vergleiche Antworten aus verschiedenen Stellen. Wenn sie sich unterscheiden, ist es Caching oder Split-Horizont. Wenn die Autorität falsch ist, ist es die Aufzeichnung selbst.
Verwalten Sie Datensätze als Code oder mit ExternalDNS, planen Sie TTLs absichtlich, überwachen Sie Ihre Domains und Zertifikate, speichern Sie DNS in der Nähe von Workloads und testen Sie immer von dort aus, wo sich der Client tatsächlich befindet.
Meine Meinung: DNS ist einfach, bis es nicht ist. Behandeln Sie es wie kritische Infrastruktur, denn es ist das erste, was jede Anfrage berührt.
Desly