Text size
Auf meinem Radar6 Min. Lesezeit

GPUs für DevOps-Mitarbeiter

GPUs sind jetzt Teil der Infrastruktur. Was ein DevOps-Ingenieur über sie wissen muss.
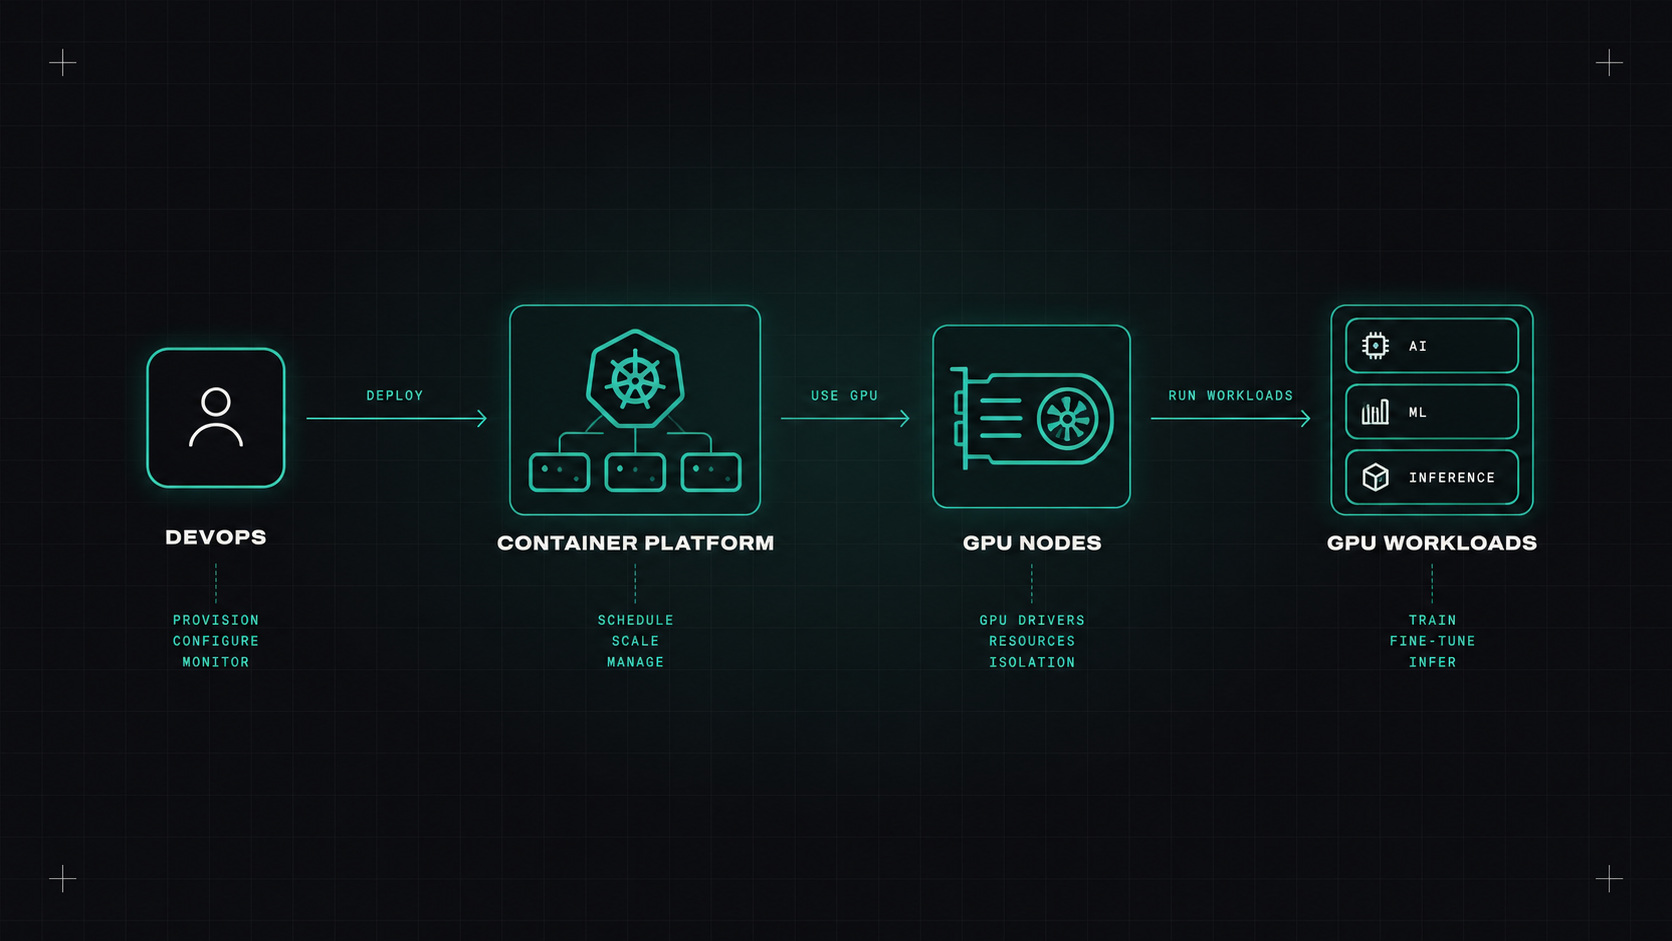
GPUs for DevOps people
KI-generierte Illustration

Für den größten Teil meiner Karriere waren GPUs etwas, worüber sich Spieler und Forscher sorgen. Die Infrastruktur, die ich betrieben habe, waren CPUs, Speicher, Festplatten und Netzwerke. Dann kam KI, und plötzlich fragten die Teams nach GPU-Knoten, Modellserving und "können wir dieses LLM selbst ausführen?"

Wenn Sie ein DevOps-Ingenieur sind, liegen GPUs wahrscheinlich bereits auf Ihrem Schreibtisch, oder werden es bald sein. Ich denke, das musst du wissen.

Warum GPUs auf meinem Schreibtisch landen

Eine CPU hat ein paar sehr leistungsstarke Kerne. Eine GPU hat tausende kleinere Kerne, die dieselben einfachen Berechnungen parallel durchführen. Neuronale Netzwerke zu trainieren und zu betreiben ist meistens diese Art von Mathematik: riesige Matrixmultiplikationen. Eine GPU kann also in Sekunden das tun, was eine CPU Minuten braucht.

Für DevOps bringt das neue Fragen mit sich:

  • Wie geben wir Arbeitslasten Zugriff auf die GPUs?
  • Wie teilen wir sie, damit sie nicht untätig sitzen?
  • Wie überwachen wir sie?
  • Wie verhindern wir, dass die Wolkenrechnung explodiert?

GPU-Grundlagen in fünf Minuten

Ein paar Begriffe, die ständig auftauchen:

  • VRAMDas ist der Speicher der GPU. Für LLM ist dies in der Regel die Grenze. Die Modellgewichte müssen passen und Platz für die Bearbeitung der Anträge geben.
  • Die: Die Softwareplattform von NVIDIA. Die meisten KI-Software hängt davon ab, weshalb NVIDIA dominiert.
  • Fahrer: GPUs benötigen spezifische Treiber auf dem Host, die der CUDA-Version entsprechen, die Ihre Software erwartet. Versionenverschiedenheiten sind eine klassische Schmerzquelle.
  • Generationen: RechenzentrumsgPUs wie NVIDIA A100, H100, H200 und neuere, sowie kleinere und günstigere wie die L4 und T4. Teurer ist nicht immer besser für die Arbeitsbelastung.

Gemeinsame GPU: MIG und Zeitschnitt

Eine vollständige GPU ist oft viel mehr als ein kleines Modell braucht. Optionen zur Weitergabe:

  • MIG (Mehrfach-GPU): unterstützt auf High-End-NVIDIA-GPUs. Teilt eine GPU in mehrere vollständig isolierte Slices, jede mit ihrem eigenen Speicher und Rechenprozess. Gute Isolation, feste Größen.
  • Zeitschnitt: mehrere Arbeitslasten wechseln sich an derselben GPU ab. Flexibler, aber keine Speicherisolation, also kann eine gierige Arbeitsbelastung andere beeinflussen.
  • MPS (Mehrprozessdienst): ermöglicht es Prozessen, eine GPU effizienter zu teilen, mit einigen Einschränkungen.

Für kleine Modelle kann das Teilen die Kosten drastisch senken.

Eine ledige GPU ist das teuerste Ding in Ihrem Rechenzentrum, das nichts tut.

Ich habe sie auf Kubernetes ausgeführt.

Auf Kubernetes ist das übliche:

  1. Ein GPU-Node-Pool Normalen Arbeitslasten fallen keine teuren GPU-Knoten zu.
  2. Der NVIDIA GPU-Operator, die Treiber, das Container-Toolkit, das Gerätesplugin und die Überwachung auf GPU-Knoten automatisch installiert.
  3. Die Pods benötigen GPUs Wie jede andere Ressource:
resources:
  limits:
    nvidia.com/gpu: 1
  1. Toleranzen und Knotenwählungen Also landen die GPU-Kapseln auf den richtigen Knoten.

Kubernetes hat jetzt Dynamische Ressourcenzuteilung (DRA), die stabil ist und es Workloads ermöglicht, bestimmte GPU-Modelle, Mindestspeichergrößen oder Slices einer GPU anzufordern. Dieser Entwicklung werden wahrscheinlich weitere Werkzeuge folgen.

Die Datenbank ist eine sehr wichtige Schreiner (auf AWS) können GPU-Knoten nur hinzufügen, wenn GPU-Pods warten, und sie danach entfernen.

ÜberwachungsgPU

Normale Knotenüberwachung sagt dir nicht viel über GPUs. Hinzufügen der NVIDIA DCGM-Exporteur für Prometheus, das Ihnen:

  • GPU-Auslastung
  • Verwendetes Speicher
  • Temperatur und Leistung
  • Fehler (ja, GPUs versagen auch, und einige Fehler bedeuten, dass der Knoten entleert werden sollte)

Das wichtigste Dashboard: Auslastung im Zeitablauf pro Arbeitslast. Es zeigt sofort, wer für die GPUs bezahlt und nicht benutzt.

Für GPUs bezahlen, die nichts tun.

Die GPU-Kosten müssen aktiv verwaltet werden:

  • Skala auf Null Wenn es keinen Verkehr gibt, wenn die Startzeit es erlaubt.
  • Die richtige Größe: eine kleinere GPU oder ein Stück davon reicht oft aus.
  • Spot- oder vorgängige Instanzen für Ausbildungs- und Chargenarbeiten, die unterbrochen werden können.
  • Zeitplan Experimente und Batcharbeit außerhalb der Hauptverkehrszeiten.
  • Showback: die GPU-Kosten pro Team sichtbar machen. Das Verhalten ändert sich schnell, wenn die Leute die Zahl sehen.

Also, müssen DevOps-Ingenieure GPUs lernen?

Wenn Ihre Firma etwas ernsthaftes mit KI macht, ja. Sie müssen nicht die Mathematik verstehen, aber Sie müssen wissen, wie man GPUs planen, teilen, überwachen und bezahlen kann. Dieses Wissen wird schnell zu einer Kernkompetenz der Infrastruktur.

Meine Meinung: GPUs sind nur eine weitere Ressource mit einem sehr hohen Preis. Behandeln Sie sie mit der gleichen Disziplin wie alles andere, nur noch mehr.

Desly