DevOps-Interview-Fragen, die ich stellen würde
Die Fragen und wie eine gute Antwort klingt.
Die Fragen und wie eine gute Antwort klingt.
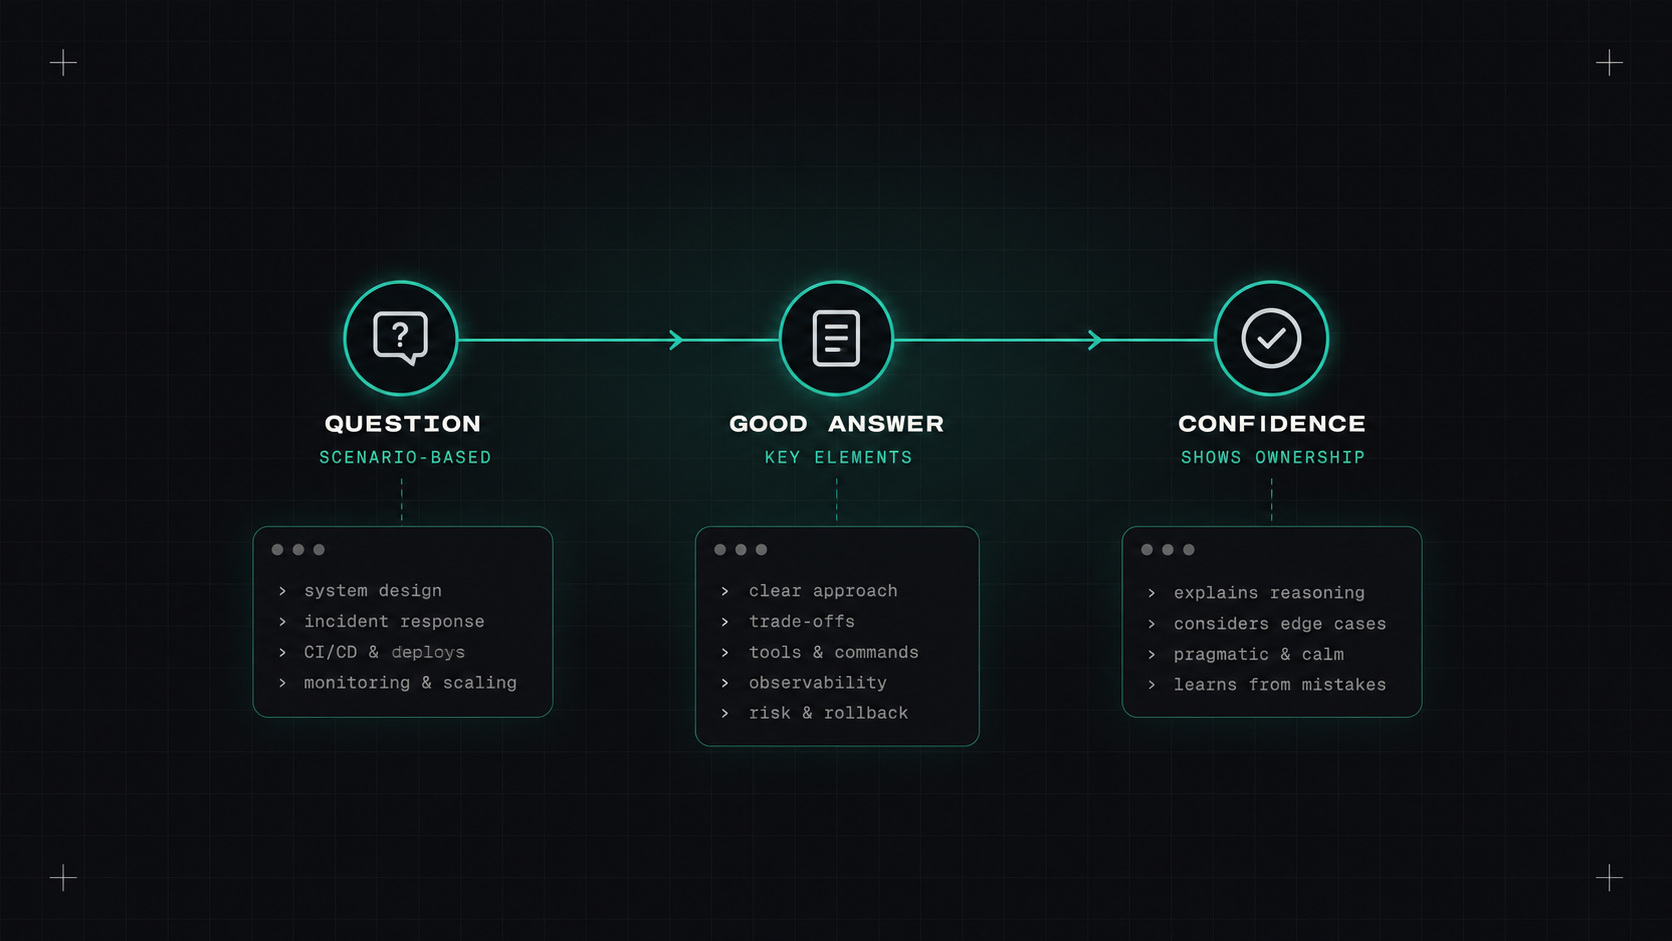
DevOps-Interviews können unberechenbar sein. Eine Firma bittet Sie, eine verknüpfte Liste umzukehren, eine andere möchte, dass Sie eine globale Infrastruktur in 45 Minuten entwerfen, eine dritte fragt nach Ihrer Lieblingsfunktion von Kubernetes.
Wenn ich jemanden für eine DevOps-Rolle interviewe, würde ich Folgendes fragen und, noch wichtiger, was ich hören würde. Das Ziel sind nicht auswendig gelernte Definitionen. Es ist Verständnis, Erfahrung und wie man denkt.
Ich interessiere mich für drei Dinge:
"Ich weiß es nicht, aber ich finde es so heraus" ist eine tolle Antwort. Selbstbewusst Dinge zu erfinden, ist nicht.
"Was passiert, wenn man eine URL in einen Browser eingibt und auf Enter drückt?" Ein Klassiker aus gutem Grund. Ich höre auf DNS-Auflösung, TCP-Verbindung, TLS-Handschlag, HTTP-Anfrage, Lastbalancer, Anwendung, Antwort. Bonuspunkte für Caching, CDN und wo Dinge schief gehen können.
"Ein Server ist langsam. Wie ermitteln Sie?"
Gute Antworten haben eine Methode: Überprüfung der Last und der CPU (top, uptime), Speicher (free, OOM tötet in dmesg), Festplattenraum und E/A (df, iostatDie Daten werden dann von den Anwendern über das Netzwerk, dann von den eigenen Logs und Metriken der Anwendung erfasst. Beginnen Sie breit, dann schmalen Sie.
"Die Scheibe ist voll, aber du zeigt keine großen Akten. Was ist los?"
Löschte Dateien, die noch von einem Prozess geöffnet werden (lsof +L1), oder der Inodes ausgehen (df -i) Das unterscheidet Leute, die echte Systeme debuggen, von denen, die es nicht getan haben.
"Was ist eigentlich ein Behälter?" Ich will von Linux Namespaces und cgroups hören, nicht nur von "einer leichten VM". Und der Unterschied zwischen einem Bild und einem Behälter.
"Eine Kapsel ist im CrashLoopBackOff. Erzähl mir, wie ich es debuggen soll".
kubectl describe pod (Vorfälle) kubectl logs --previous, Überprüfen Sie Konfiguration und Geheimnisse, Ressourcenlimits (OOMKilled?), Sonden töten es zu früh, Bild und Befehl. Eine methodische Antwort ist wichtiger als die spezifische Ursache.
"Was ist der Unterschied zwischen Anfragen und Grenzen? Was passiert, wenn ein Container seine Speichergrenze überschreitet? Ist das CPU-Limit?" Erinnerung: "OOM getötet". CPU: geschwächt. Die Anfragen entscheiden über die Planung. Große Kandidaten erwähnen QoS-Klassen oder die CPU-Grenzdebatte.
"Wie erreicht eine Anfrage aus dem Internet eine Kapsel?" DNS, Lastbalancer, Gateway oder Ingress Controller, Service, Endpunkte, Kapsel. Bonus für kube-Proxy oder eBPF und NetworkPolicies.
"Wie würden Sie eine Null-Ausfallzeit-Einführung machen?" Rollende Updates mit Bereitschaftsproben, PodDisruptionBudgets, anmutigem Abschaltmanagement, rückwärtskompatiblen Datenbankmeldungen, Kanarien- oder Blaugrün für riskante Änderungen.
Ich nehme nicht ein, weil ich jede Flagge kenne. Ich nehme sie an, weil sie wissen, wie man es herausfindet und wann man vorsichtig sein muss.
"Beschreiben Sie eine gute CI/CD-Pipeline". Schnelles Feedback zuerst, einmal bauen und überall das gleiche Artefakt einsetzen, automatisierte Tests und Sicherheitsscans, schrittweise Einführung, einfacher Rücklauf. Hören Sie auf das "Warum", nicht nur auf die Phasen.
"Was ist der Terraform-Zustand und warum ist er wichtig?"
Die Verknüpfung zwischen Code und realen Ressourcen. Fernbedienung, verschlüsselt, verändert. Es enthält Geheimnisse. Gute Kandidaten erwähnen moved und import oder was passiert, wenn der Staat verloren geht.
"Jemand hat eine Ressource manuell in der Konsole geändert. Was passiert, wenn Terraform das nächste Mal läuft?" Terraform versucht, es umzukehren. Wie man es erkennt, wie man entscheidet, ob Code oder Realität gewinnt, wie man es verhindert.
"Wie verhält man sich mit Geheimnissen in einer Pipeline?" Nicht in Git, nicht in einfachen CI-Variablen, wenn vermeidbar. OIDC für Cloud-Zugriff, ein geheimer Manager, kurzlebige Anmeldeinformationen, Verhüllung in Protokollen.
Ich liebe offene Szenarien, weil sie zeigen, wie jemand denkt:
"Nach einer Einführung steigen die Fehlerraten auf 10%. Was machst du?" Erstens: Minderung. Zurück, wenn die Verteilung die wahrscheinliche Ursache ist. Dann untersuchen Sie: Was hat sich geändert, welche Endpunkte versagen, Protokolle, Spuren. Mit den Interessengruppen kommunizieren. Danach eine schuldlose Obduktion. Die besten Kandidaten erwähnen einen frühen Rückzug.
"Benutzer in einer Region berichten, dass die Website langsam ist; andere sind in Ordnung". DNS und Routing, CDN, regionale Infrastruktur, Abhängigkeit in dieser Region, Netzwerkweg. Wie würden Sie jede Hypothese bestätigen?
"Deine Cloud-Rechnung hat sich in diesem Monat verdoppelt. Wie weißt du, warum?" Kosten-Explorer nach Dienst, Konto und Tag, auf der Suche nach neuen Ressourcen, Datenübertragung, Protokolle oder einem ausgehenden Autoscaler. Dann die Prävention: Budgets, Warnungen, Kennzeichnung.
"Entwerfen Sie die Infrastruktur für eine Webanwendung, die den Verlust einer Verfügbarkeitszone überstehen muss". Ich suche: mehrere AZs, Lastbalancing, staatlose App-Ebene mit Autoscaling, verwaltete Datenbank mit Multi-AZ Failover, Backups in einer anderen Region, Infrastruktur als Code, Überwachung und Warnungen, eine Bereitstellungsstrategie. Und der Kandidat stellt Fragen: Wie viel Verkehr, wie ist das Budget, wie ist die akzeptable Ausfallzeit?
Klarstellende Fragen stellen ist eines der stärksten Signale in einem Designinterview.
Dinge bauen, Dinge brechen und erklären können, was passiert ist. Üben Sie, laut über Ihren Debug-Prozess zu sprechen. Und bereiten Sie zwei oder drei echte Geschichten aus Ihrer Erfahrung vor: einen Ausfall, eine Automatisierung, eine Meinungsverschiedenheit. Sie sind oft das, woran sich die Interviewer am meisten erinnern.
Meine Meinung: Die besten DevOps-Interviews fühlen sich an, als würden Sie gemeinsam ein Problem lösen. Zeigen Sie, wie Sie denken, geben Sie zu, was Sie nicht wissen, und bleiben Sie neugierig.
Desly