Profilierung in der Produktion: wohin die CPU tatsächlich geht
Die Messungen sagen, dass etwas langsam ist. Die Profile sagen, warum.
Die Messungen sagen, dass etwas langsam ist. Die Profile sagen, warum.
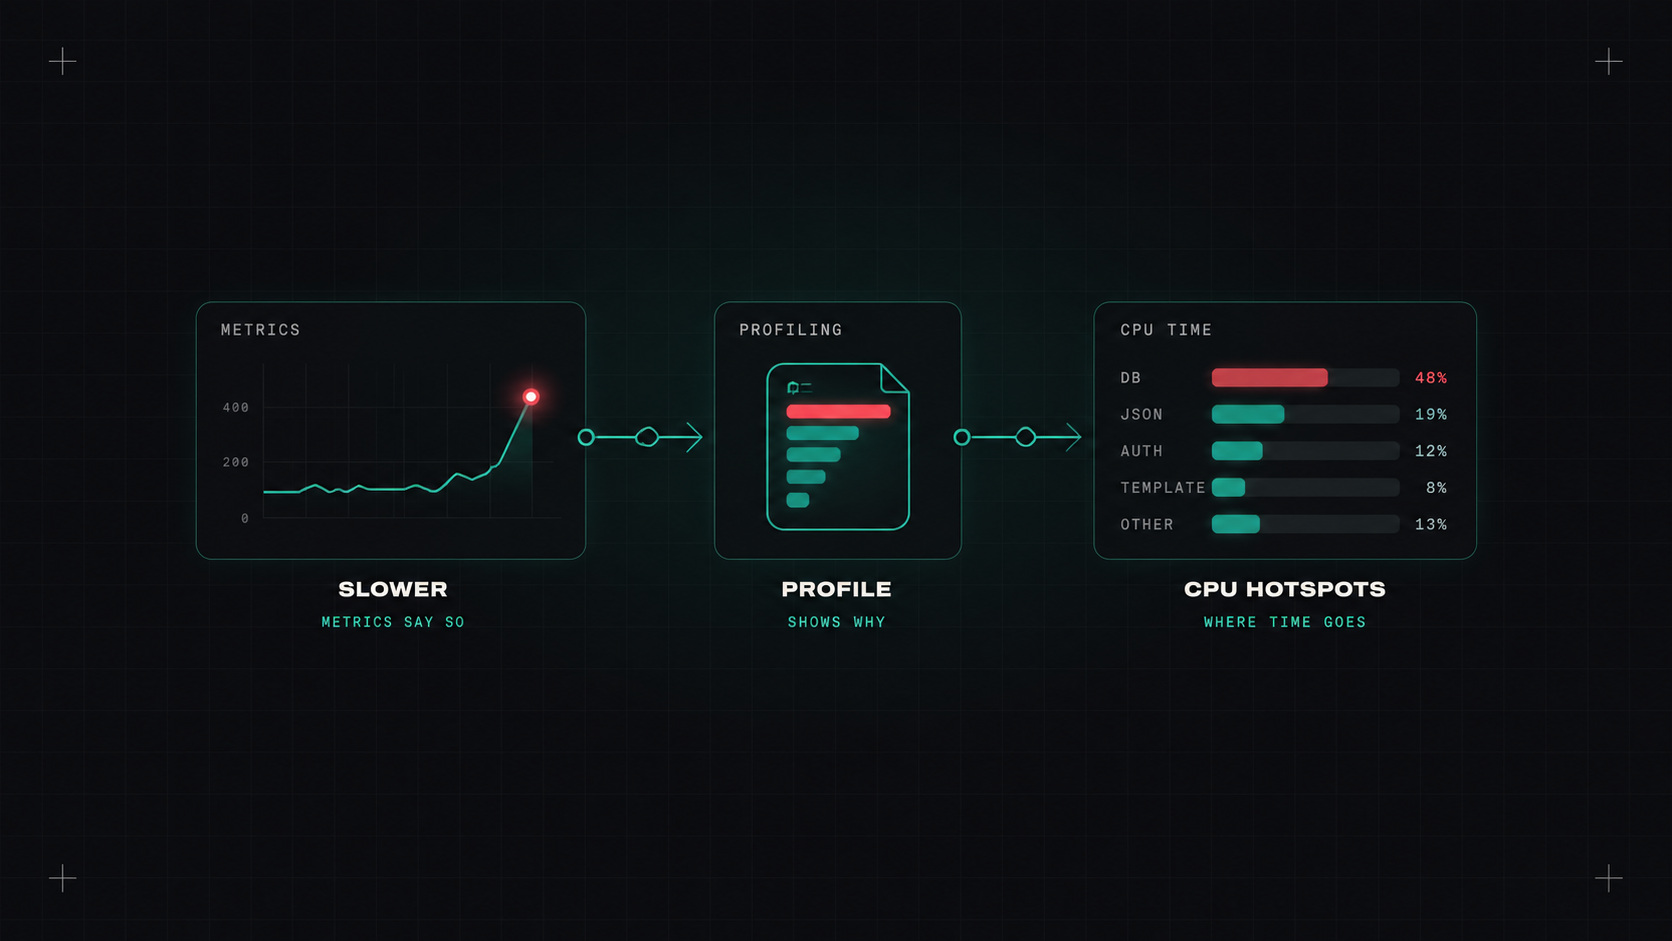
Hier ist eine bekannte Situation. Ein Dashboard zeigt einen Dienst, der viel mehr CPU verwendet, als er sollte. Die Latenz nimmt zu. Sieh dir die Kennzahlen an: Ja, die CPU ist hoch. Sie sehen sich die Spuren an: Anfragen sind langsam, aber innerhalb des Dienstes, nicht in seinen Abhängigkeiten. Sieh dir die Protokolle an: nichts Ungewöhnliches.
Was Sie wirklich wissen wollen ist: Welcher Code Verbraucht die ganze CPU? Das ist, was Profiling Antworten. Und die kontinuierliche Profilung beantwortet das die ganze Zeit, in der Produktion.
A Profil Aufzeichnungen, in denen ein Programm seine Ressourcen aufwendet, bis hin zu einzelnen Funktionen und Zeilen:
Die Profile werden in der Regel wie folgt dargestellt: Flammendiagramme: jede Balke ist eine Funktion, ihre Breite zeigt, wie lange es dauerte, und Funktionen, die sie aufgerufen hat, sind oben gestapelt. Breite Balken sind, wo die Zeit vergeht. Sie können auf einen Blick sehen, dass zum Beispiel 30% der CPU in JSON-Serialisierung gehen, oder ein Regex wird bei jeder Anfrage kompiliert.
Die Messwerte sagen, dass Ihr Service langsam ist. Ein Flammendiagramm zeigt auf die Codezeile, die es langsam macht.
Entwickler haben seit Jahrzehnten Code profiliert, aber normalerweise lokal, für ein paar Minuten, mit speziellen Tools. Das Problem: Die Produktion verhält sich anders. Unterschiedliche Daten, unterschiedlicher Verkehr, unterschiedliche Last.
Kontinuierliche Profilung Profile aus der Produktion ständig sammeln, mit geringen Overheadkosten, und speichern, damit Sie:
Es gibt zwei Möglichkeiten, die Einnahmen zu sammeln:
Die übliche erste Frage: verlangsamt die Profilisierung die Produktion? Moderne kontinuierliche Profiler sammeln, indem sie zum Beispiel den Stapel hundertmal pro Sekunde betrachten, anstatt jeden Funktionsanruf zu verfolgen. Der Overhead ist in der Regel gering, oft etwa 1% der CPU, abhängig vom Tool und den Einstellungen.
Verglichen mit den Einsparungen, die es oft findet, ist das ein sehr gutes Geschäft. Aber testen Sie es auf Ihren Arbeitslasten und beginnen Sie mit ein paar Diensten.
Hier lohnt sich die kontinuierliche Profilbildung. Häufige Erkenntnisse, wenn sich Teams erstmals Flotten-Flammengraphen ansehen:
Ein einziges breites Balken in der Flammengrafik eines Dienstes, der auf Hunderten von Kernen läuft, zu fixieren, kann echtes Geld sparen. Deshalb ist Profiling immer mehr Teil von FinOps-Gesprächen, nicht nur Leistungs-Tuning.
Dieser erste Vergleich, eine sichtbar schmalere Stange und ein niedrigeres CPU-Grafiken, ist in der Regel das, was den Rest des Teams überzeugt.
Für jedes Team, das Dienstleistungen in großem Maßstab betreibt, ja. Kontinuierliches Profiling füllt die Lücke zwischen "der Service ist langsam" und "hier ist der Grund", und es findet regelmäßig Einsparungen, die für den gesamten Beobachtungsstapel bezahlen.
Meine Meinung: Rate nicht, wohin deine CPU geht. Sieh mal. Die Flammen-Grafik ist normalerweise ehrlicher als wir alle.
Desly