Warnungen, die es wert sind, dich aufzuwecken
Wenn eine Alarmmeldung keine Aktion erfordert, sollte sie niemanden anrufen.
Wenn eine Alarmmeldung keine Aktion erfordert, sollte sie niemanden anrufen.
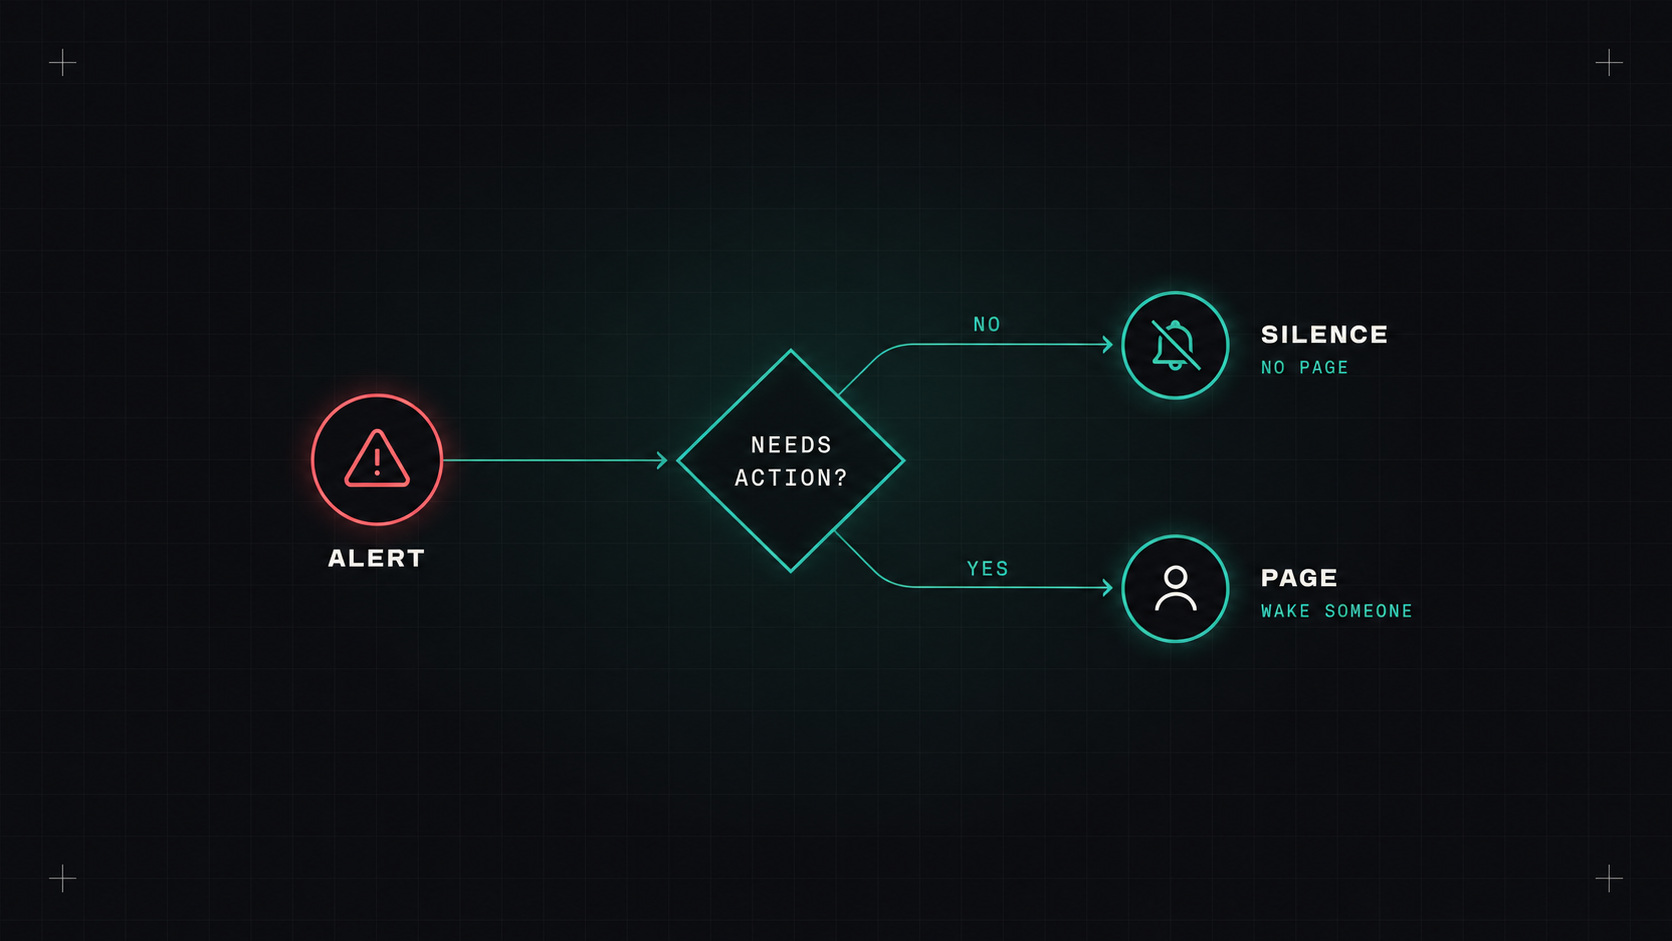
Die schlimmste Schicht ist nicht die mit einem großen Ausfall. Es ist der mit 40 kleinen Warnungen, von denen keiner etwas brauchte. Die Scheibe ist bei 81%. CPU-Spitze, die sich von selbst lösten. Eine Kapsel wurde einmal neu gestartet. Man erkennt an, dass sie halb schlafen, und am Morgen sind Sie erschöpft und nichts war wirklich falsch.
Wenn man das ein paar Monate lang tut, ignorieren die Leute Alarme. Dann wird auch die echte ignoriert.
Eine gute Alarmierung ist eine Designdisziplin. Hier sind die Regeln, denen ich folge.
Bevor Sie eine Benachrichtigung erstellen, die jemanden anruft, fragen Sie:
Wenn die Antwort auf eines dieser Fragen nein ist, sollte es keine Seite sein. Es kann ein Ticket sein, eine Chat-Nachricht, ein Armaturenbrett oder nichts.
Eine nützliche Spaltung:
Eine Alarmmeldung, die keine Aktion erfordert, ist keine Alarmmelding. Es ist Lärm mit einer Telefonnummer.
Symptome Die meisten der Probleme, die die Nutzer haben, sind Fehler, Langsamkeit, Nichtverfügbarkeit. Ursachen Das könnte dazu führen: hohe CPU, ein Neustart, eine volle Warteschlange.
Warnen Sie vor Symptomen. Hohe CPU ist kein Problem, wenn die Anfragen schnell sind. Ein neu gestartetes Pod ist kein Problem, wenn die Benutzer es nicht bemerken. Aber eine Fehlerquote von 5% bei der Abrechnung ist ein Problem, unabhängig davon, was sie verursacht hat.
Die Ursachen sind immer noch wichtig, wie Kontext Auf Dashboards oder als Tickets, wenn sie zukünftige Probleme vorhersagen (wie eine Festplatte, die in drei Tagen voll ist).
Die besten Symptomwarnungen basieren auf SLO und Verbrennungsraten: Seite, wenn das Fehlerbudget schnell genug brennt, um zu zählen.
Ein Problem sollte nicht 20 Benachrichtigungen hervorrufen. In Prometheus Alertmanager (und die meisten Warnmittel):
route:
  receiver: default
  group_by: ["alertname", "cluster", "service"]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
  - matchers: [severity="critical"]
    receiver: pagerduty-oncall
  - matchers: [severity="warning"]
    receiver: team-chat

inhibit_rules:
- source_matchers: [alertname="ClusterDown"]
  target_matchers: [severity=~"warning|critical"]
  equal: ["cluster"]
Für die Paging-Schicht verarbeiten Tools wie PagerDuty, incident.io, Grafana OnCall (und Grafanas IRM-Funktionen), Opsgenie-Alternativen und andere Zeitpläne, Eskalation und Bestätigung. (Atlassian hat den Verkauf von Opsgenie beendet, so dass sich die Teams, die es verwenden, woanders bewegen.)
Wenn um 3 Uhr morgens ein Alarm ausgelöst wird, kennt die Person, die auf Warteschalter steht, den Dienst vielleicht nicht gut. Jede Alarmmeldung sollte eine Verbindung zu einem Laufbuch:
Setzen Sie den Runbook-Link direkt in die Alarmanotationen. Wenn Sie kein Runbook für eine Warnung schreiben können, ist das ein starkes Zeichen, dass die Warnung nicht umsetzbar ist.
Die Alarme verrotten. Die Dienstleistungen ändern sich, die Schwellenwerte werden falsch, die Besitzer ziehen weiter. Eine monatliche Überprüfung der Alarmmeldungen mit dem Einsatzteam wirkt Wunder:
Die Daten werden in der Regel in der Regel von der Arbeitszeit abgelesen. Aktionierbarkeitsrate (Prozentsatz der Seiten, die Maßnahmen benötigten).
for: Dauer Also, kurze Blitze nicht auf Page: for: 5m bei den meisten Warnungen.promtool.Liste alle Alarme auf, die jemanden im letzten Monat gepagt haben. Für jeden Fragen: Brauchte es dann wirklich Handlung? Die, die nicht funktioniert haben, runtergraduieren oder löschen. Sie werden wahrscheinlich die Hälfte davon entfernen, und niemand wird sie vermissen.
Ich sage: Schützen Sie den Schlaf Ihrer Wachingenieure, als wäre es ein Produktionssystem. Weil es das ist.
Desly