SLO: Entscheidung, wie zuverlässig zuverlässlich genug ist
100% Betriebszeit ist das falsche Ziel. Wie Fehlerbudgets Teams helfen, Entscheidungen zu treffen.
100% Betriebszeit ist das falsche Ziel. Wie Fehlerbudgets Teams helfen, Entscheidungen zu treffen.
Wenn man einen Manager fragt, wie zuverlässig ein Dienst sein sollte, wird er meistens "100%" sagen. Das klingt richtig. Wer will Pause?
Aber 100% ist unmöglich, und es ist unglaublich teuer, es zu verfolgen. Jede zusätzliche "neun" der Verfügbarkeit kostet mehr als die letzte. Und Ihre Nutzer können nicht den Unterschied zwischen 99,99% und 100% erkennen, weil ihr eigenes WLAN, Telefon und ISP viel häufiger ausfallen.
Service Level Objectives (SLOs) sind eine Möglichkeit, absichtlich zu bestimmen, wie zuverlässig zuverlässlich genug ist.
SLI (Service Level Indicator): eine Messung der Leistung Ihres Dienstes aus Sicht des Nutzers. Zum Beispiel: der Prozentsatz der erfolgreichen HTTP-Anfragen oder der Prozentualwert, der in weniger als 300 ms bereitgestellt wird.
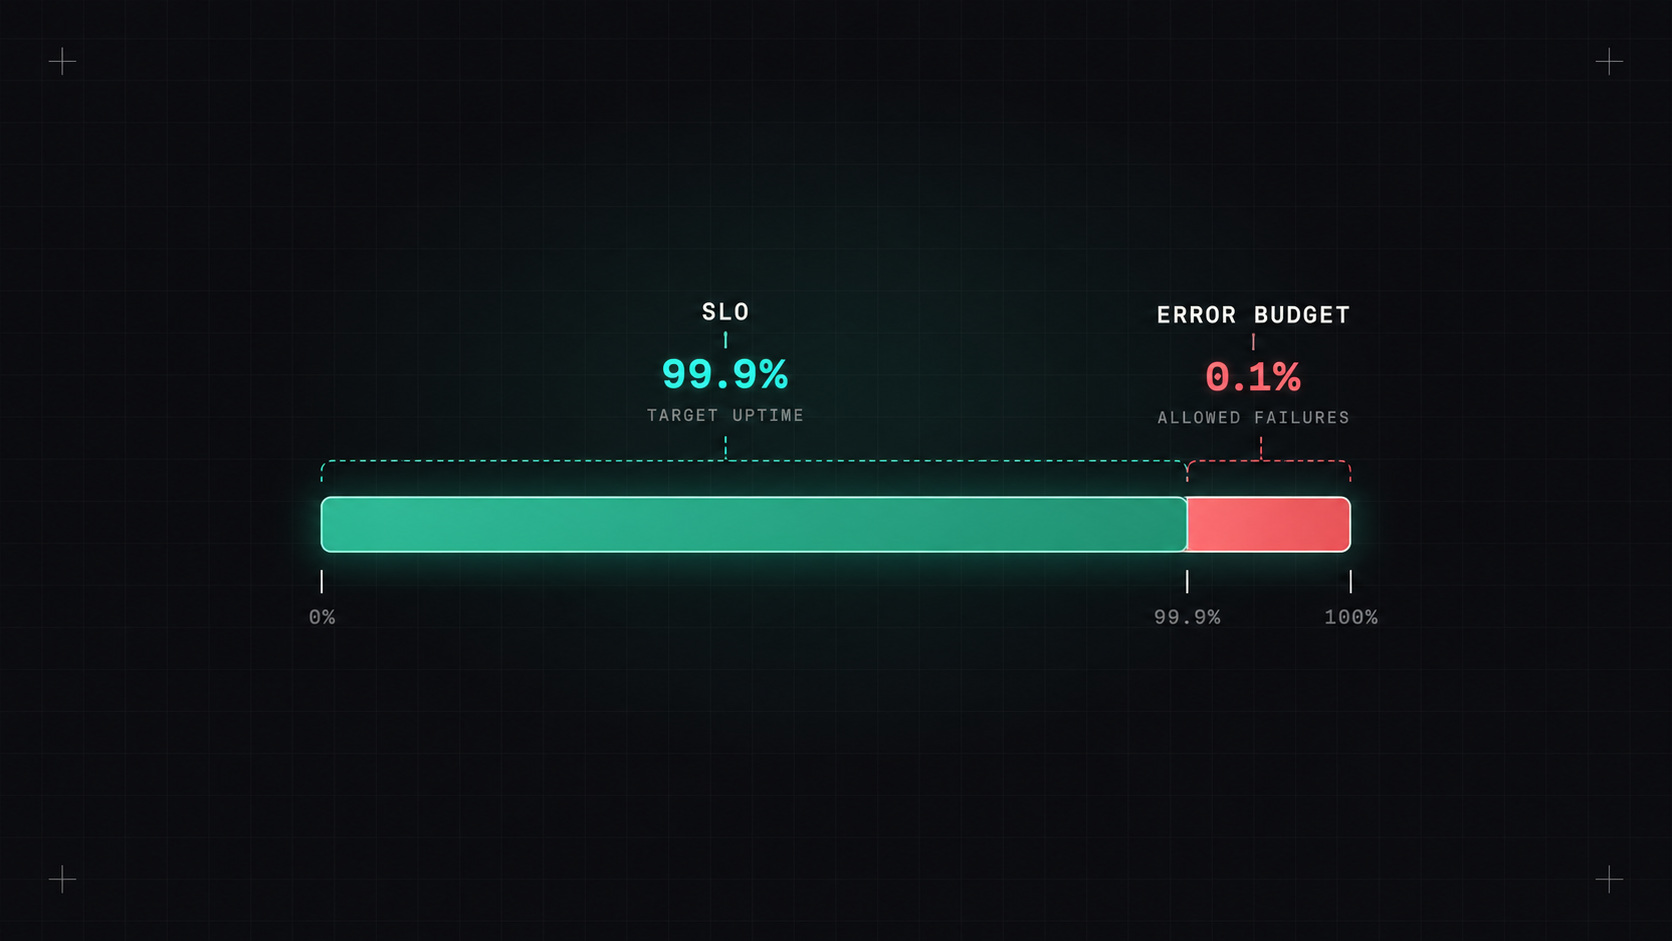
SLO (Service Level Objective) (Ziel für die Leistungsbereitschaft): ein Ziel für diesen Indikator über ein Zeitfenster. Zum Beispiel: 99,9% der Anfragen gelingen, gemessen über 30 Tage.
Fehlerbudget: die Anzahl der Fehler, die der SLO zulässt. Mit einem Ziel von 99,9% über 30 Tage können Sie sich 0,1% fehlgeschlagene Anfragen leisten, oder ungefähr 43 Minuten vollständige Ausfallzeit.
SLA (Service Level Agreement) (Abkommen über die Leistungsfähigkeit): ein Vertrag mit Kunden, der in der Regel finanzielle Konsequenzen hat. SLAs sollten locker sein als Ihre internen SLOs, damit Sie Probleme bemerken, bevor Sie jemandem Geld schulden.
Das Fehlerbudget verwandelt die Zuverlässigkeit von einem Argument in eine gemeinsame Zahl.
Produkt und Engineering streiten sich nicht mehr darüber, ob wir an Zuverlässigkeit oder Funktionen arbeiten sollen.
Ein SLO ist kein Versprechen, dass nichts gebrochen wird. Es ist eine Vereinbarung, wie viel Bruch akzeptabel ist und was wir tun, wenn wir überfahren.
Gute SLI messen, was Benutzer tatsächlich erleben:
Messen so nah wie möglich am Benutzer: am Lastgleichgerät oder am Gateway, nicht tief im Dienst. Vermeiden Sie SLI wie "CPU unter 80%": Benutzern ist die CPU egal.
Ein paar praktische Ratschläge:
| SLO | Erlaubte Ausfallzeiten pro 30 Tage |
|---|---|
| 99% | ca. 7 Stunden und 12 Minuten |
| 99.5% | ca. 3 Stunden und 36 Minuten |
| 99.9% | Ungefähr 43 Minuten. |
| 99.95% | etwa 22 Minuten |
| 99.99% | ca. 4 Minuten |
Wenn man diesen Tisch anschaut, beendet man das Gespräch meist schnell.
SLOs machen auch die Alarmierung viel besser. Anstatt auf CPU oder individuelle Fehler zu warnen, warnen Sie auf, wie schnell Sie sind Brennen das Fehlerbudget.
Das Google SRE Workbook empfiehlt Mehrfachfenster- und Mehrfachverbrennungswarnungen, zum Beispiel: Seite, wenn Sie 2% des monatlichen Budgets in der letzten Stunde verbrannt haben (und die letzten fünf Minuten bestätigen, dass es immer noch passiert). Das fängt echte Vorfälle schnell auf und ignoriert kurze Blitze.
Diese Prometheus-Regeln von Hand zu schreiben, ist langweilig und fehleranfällig. Die Tools erzeugen sie aus einer einfachen SLO-Definition:
# Sloth example
version: "prometheus/v1"
service: "shop-api"
slos:
  - name: "requests-availability"
    objective: 99.9
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="shop-api",code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="shop-api"}[{{.window}}]))
    alerting:
      page_alert:
        labels:
          severity: critical
Wählen Sie Ihren wichtigsten benutzerorientierten Dienst. Definition eines SLI zur Verfügbarkeit und eines SLI für Latenzzeit. Setzen Sie Ziele, basierend auf den echten Daten des letzten Monats. Fügen Sie Brennrate-Alarme hinzu, zeigen Sie das Budget auf einem Dashboard und überprüfen Sie es alle paar Wochen als Team.
Meine Meinung: Perfektion ist nicht das Ziel. Genau zu wissen, wie unvollkommen man sein kann, und danach zu handeln, ist.
Desly