Ein Monitoring-Stack mit Prometheus 3 und Grafana
Was ist neu in Prometheus 3 und der Stapel, den ich heute eingerichtet habe.
Was ist neu in Prometheus 3 und der Stapel, den ich heute eingerichtet habe.
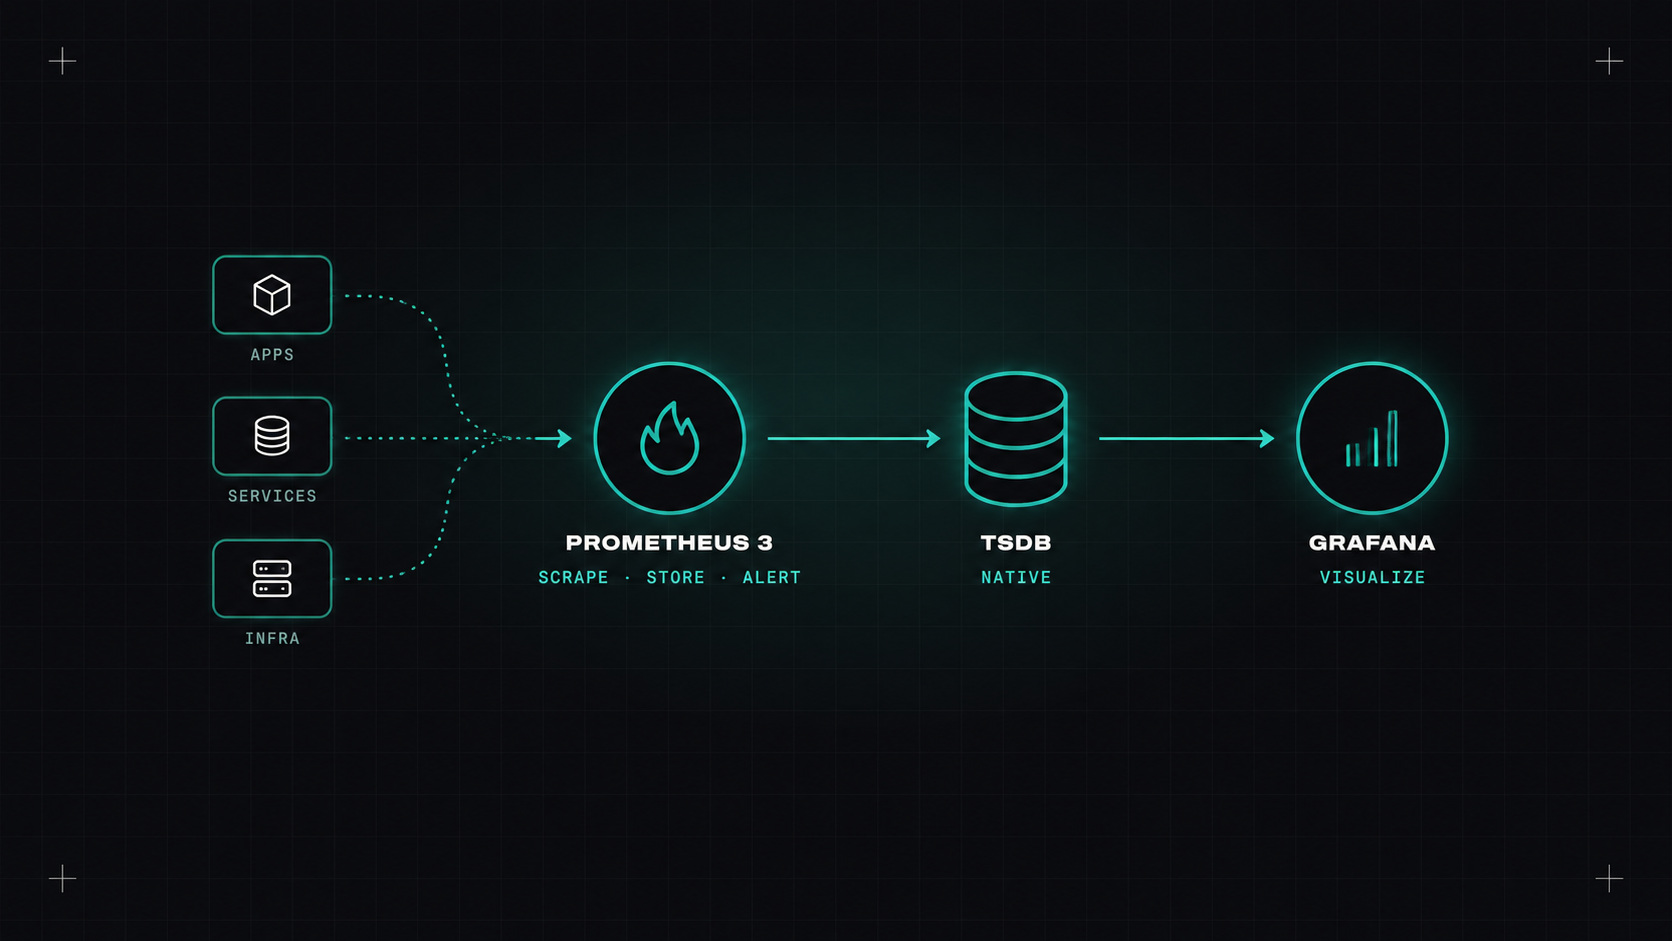
Prometheus ist seit fast einem Jahrzehnt das Rückgrat der Kubernetes-Überwachung. Es war das zweite Projekt, das sich nach Kubernetes selbst dem CNCF anschloss. Ende 2024 kam dann Prometheus 3.0, die erste große Version seit sieben Jahren.
Hier ist, was sich geändert hat, und der Monitoring-Stack, den ich heute für eine typische Kubernetes-Setup bauen würde.
Eine neue Web-Benutzeroberfläche. Von Grund auf neu aufgebaut, mit einem modernen Abfrageeditor, besserer Autovervollständigung und einer "Erklären"-Ansicht, die PromQL-Abfragen aufteilt. Es fühlt sich endlich wie ein Werkzeug aus diesem Jahrzehnt an.
Unterstützung für OpenTelemetry. Prometheus kann jetzt Metriken über OTLP - Ich bin direkt hier. Anwendungen mit OpenTelemetry können Metriken ohne zusätzliche Übersetzungsschicht auf Prometheus schieben.
UTF-8-Metriken und Etikettenamen. Prometheus erlaubte früher nur eine begrenzte Anzahl von Zeichen in Namen. Jetzt sind Punkte und andere Zeichen erlaubt, was für OpenTelemetries Naming-Konventionen wie http.server.request.duration.
Native Histogramme. Eine effizientere und genauere Möglichkeit, Latenzverteilungen zu speichern, ohne im Voraus die Bucket-Grenzen auswählen zu müssen. Sie sind über die 3.x-Veröffentlichungen reif geworden und sind für Latenzmetriken nutzenswert.
Fernschreiben 2.0. Ein effizienteres Protokoll für den Datensendungsprozess in Langzeitspeichersysteme.
Änderungen zu brechen Die Daten wurden klein gehalten, aber einige Standardeinstellungen wurden geändert (z. B. in Bezug auf Scrape-Protokolle und einige Flaggen). Lesen Sie den Übergangsanleitung vor dem Upgrade.
Auf Kubernetes ist der einfachste Weg, einen vollen Stapel zu bekommen, die Die Bezeichnung "Kube-Prometheus-Stack" Steuerkarte:
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm install monitoring prometheus-community/kube-prometheus-stack \
  --namespace monitoring --create-namespace
Es installiert:
Dann, um Ihre eigenen Apps zu schabeln, fügen Sie ein ServiceMonitor oder - Das ist PodMonitor .:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: shop-api
  namespace: shop
  labels:
    release: monitoring
spec:
  selector:
    matchLabels:
      app: shop-api
  endpoints:
  - port: http
    path: /metrics
    interval: 30s
Der Bediener nimmt es auf und konfiguriert automatisch Prometheus. Keine Bearbeitung einer zentralen Konfigurationsdatei.
Prometheus ist absichtlich einfach. Es kratzt, speichert und warnt und macht diese drei Dinge sehr gut.
Ein einzelner Prometheus-Server speichert Daten lokal, normalerweise für ein paar Wochen. Es ist nicht für die langfristige Lagerung oder für eine globale Sicht über viele Cluster ausgelegt. Dafür gibt es drei beliebte Möglichkeiten:
Für einen kleinen Haufen ist ein einfacher Prometheus mit ein paar Wochen Aufbewahrung in Ordnung. Fügen Sie eine davon hinzu, wenn Sie Monate der Geschichte oder viele Cluster in einer Ansicht benötigen.
Grafana lässt Sie Hunderte von Dashboards machen, aber die meisten Menschen schauen nie wieder auf sie. Die, die ich benutze, sind:
Halten Sie Dashboards in Git (Grafana unterstützt das Bereitstellen von Dashboards aus Dateien, und es gibt einen Grafana Operator für Kubernetes), damit sie wie Code verändert und überprüft werden.
Der Kube-Prometheus-Stack hat viele Warnungen. Einige sind ausgezeichnet, andere werden Lärm in Ihrer Umgebung sein. Durchsuchen Sie sie, halten Sie, was handlungsfähig ist, und fügen Sie Warnungen basierend auf Symptome (Fehlerraten, Latenzzeit, SLO-Burn-Raten) für Ihre eigenen Dienste.
- Schicken Sie sie durch. Alertmanager mit Gruppierung (eine Benachrichtigung für verwandte Warnmeldungen), Hemmung (nicht bei einem ganzen Cluster auf alles alarmieren) und unterschiedlichen Empfängern für unterschiedliche Schweregrade.
Installieren Sie kube-prometheus-stack in einem Testcluster, fügen Sie einen ServiceMonitor für eine Ihrer Apps hinzu und erstellen Sie ein einziges RED-Dashboard dafür. Upgrade auf Prometheus 3, wenn du es noch nicht getan hast, und probiere die neue Benutzeroberfläche aus. Langzeitlager können warten, bis Sie sie wirklich brauchen.
Meine Meinung: Prometheus 3 behält alles, was Prometheu großartig machte, und spricht endlich OpenTelemetry. Es ist immer noch der beste Ort, um zu beginnen.
Desly