Mehr als ein Cluster
Warum Teams am Ende viele Cluster haben und wie man verhindert, dass sie zu vielen Problemen werden.
Warum Teams am Ende viele Cluster haben und wie man verhindert, dass sie zu vielen Problemen werden.
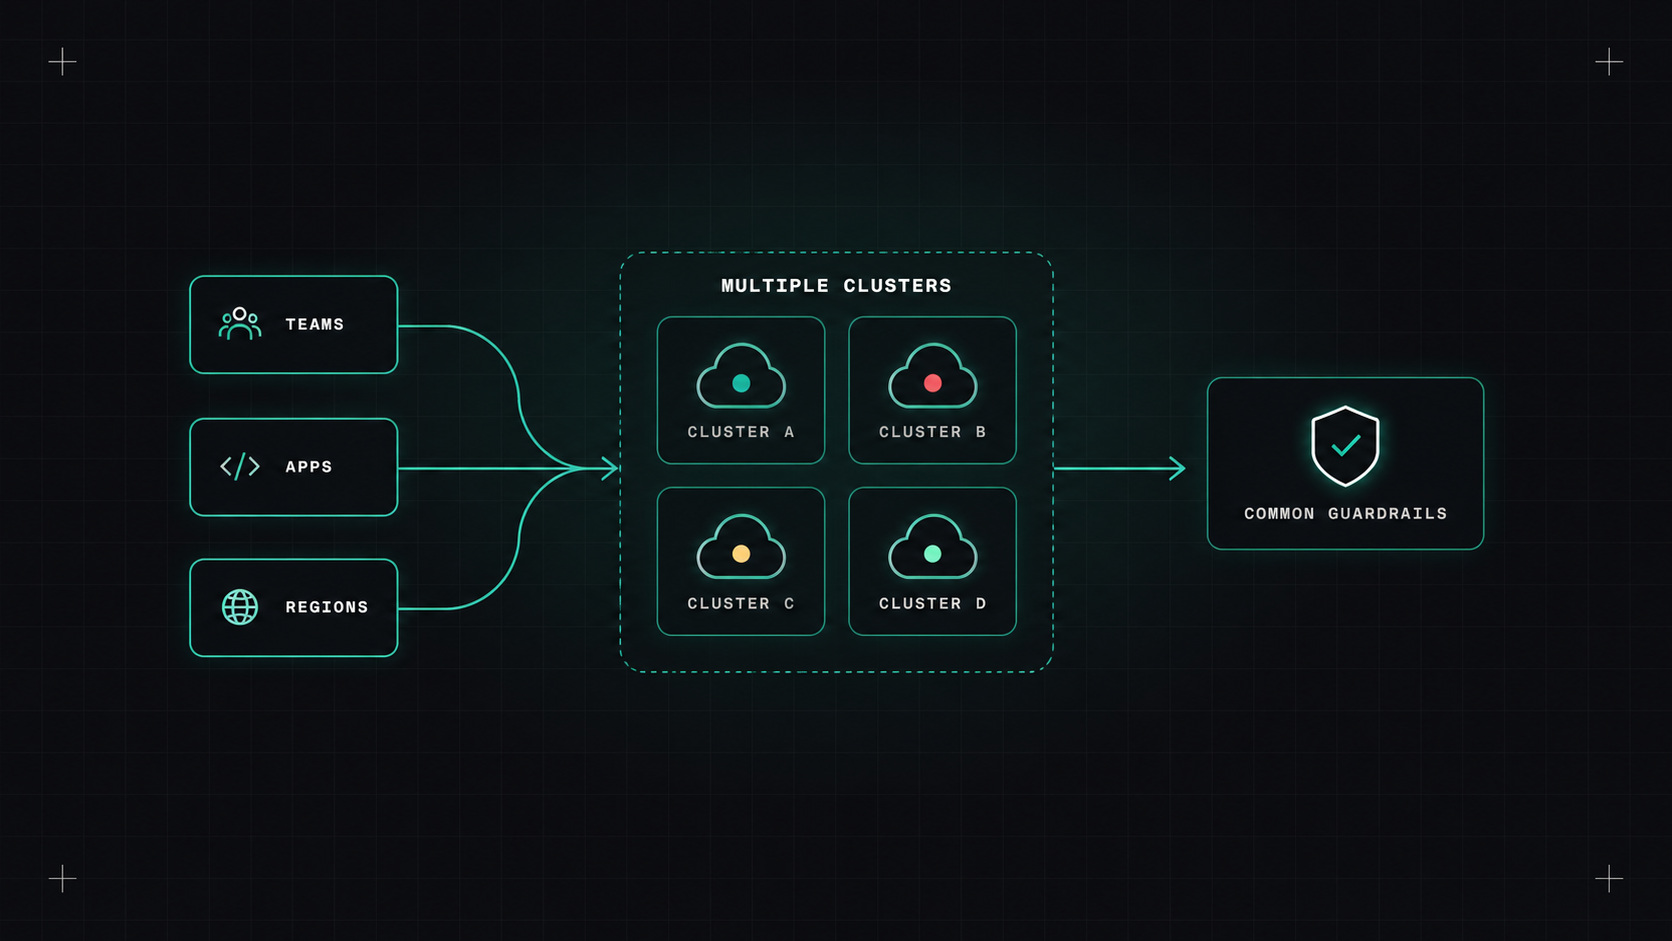
Fast jedes Unternehmen beginnt mit einem Kubernetes-Cluster. Dann eine zweite für die Inszenierung. Dann in einer anderen Region. Dann braucht ein Team aus Compliance-Gründen eigene. Dann gibt es den Rand, das Data Science Team, die Akquisition... Und plötzlich fragt jemand: "Wie viele Cluster haben wir?" Und niemand weiß die genaue Antwort.
Multi-Cluster ist keine Entscheidung, die die meisten Teams einmal treffen. Das passiert immer. Die Frage ist, ob Sie es absichtlich schaffen.
Es gibt gute Gründe, mehr als einen zu laufen:
Und einige weniger gute Gründe: Jedes Team bekommt seinen eigenen Cluster, nur weil es einfach war, einen zusammen zu klicken.
Jeder Cluster, den Sie hinzufügen, ist etwas anderes, das Sie aktualisieren, sichern, überwachen und bezahlen müssen. Jeder soll sich seinen Platz verdienen.
Wenn man mehr als ein paar Cluster hat, funktioniert es nicht mehr, Dinge von Hand zu machen. Sie brauchen einen Flottenansatz.
GitOps ist die Grundlage. Argo CD oder Flux setzen die gleiche Basislinie für jeden Cluster von Git ein: Überwachungsagenten, Richtlinien, Eintritts- oder Gateway-Controller, Cert-Manager. Argo CD Anwendungs-Sets mit dem Cluster-Generator sind besonders nützlich: definieren Sie eine Anwendung einmal, und es wird auf jedem Cluster eingesetzt, der einem Label entspricht.
Clusterlebenszyklustools die Cluster selbst erstellen und verbessern:
Standardisierung ist das, was es skalierbar macht. Cluster sollten Rinder sein, nicht Haustiere: aus denselben Vorlagen, mit derselben Basislinie, so dass jeder Ingenieur an jedem Cluster arbeiten kann.
Manchmal müssen Dienste in verschiedenen Clustern miteinander sprechen. Die Auswahlmöglichkeiten:
Mein Rat: Vermeiden Sie, wenn möglich, inter-cluster-Abhängigkeiten. Jeder Cluster, der ein komplettes Stück des Systems (z. B. eine Region) bedient, ist viel einfacher als Dienste, die ständig über Cluster hinweg anrufen.
Bei vielen Clustern wird die Zugriffssteuerung schwierig:
Jeder Cluster ist es wichtig, Messwerte, Logs und Spuren an einen zentralen Ort zu senden. Alles mit dem Clusternamen und der Region kennzeichnen. Ein Dashboard zeigt alle Cluster nebeneinander, mit Versionen und Gesundheit, und antwortet schnell: "Ist es nur dieser Cluster oder alle?"
Auch Track Versionen: welche Kubernetes-Version und welche Add-On-Versionen jeder Cluster ausführt. Versionentrieb über eine Flotte ist eine klassische Quelle von "es funktioniert in Cluster A, aber nicht B".
So wenig wie Ihre Anforderungen erlauben und so viele wie Ihre Isolation, Region und Compliance Bedürfnisse verlangen. Unabhängig von der Anzahl, verwalten Sie sie von Tag eins an als Flotte: GitOps für alles, die gleiche Basislinie überall und zentrale Beobachtbarkeit.
Meine Meinung: Multi-Cluster ist überschaubar, wenn alle Cluster gleich aussehen. Das Problem beginnt, wenn einer von ihnen etwas Besonderes wird.
Desly