Wenn Dinge kaputt gehen: Vorfälle und unschuldige Nachbeurteilungen
Die Rollen, die Nachrichten und die Postmortem-Vorlage, die ich benutze.
Die Rollen, die Nachrichten und die Postmortem-Vorlage, die ich benutze.
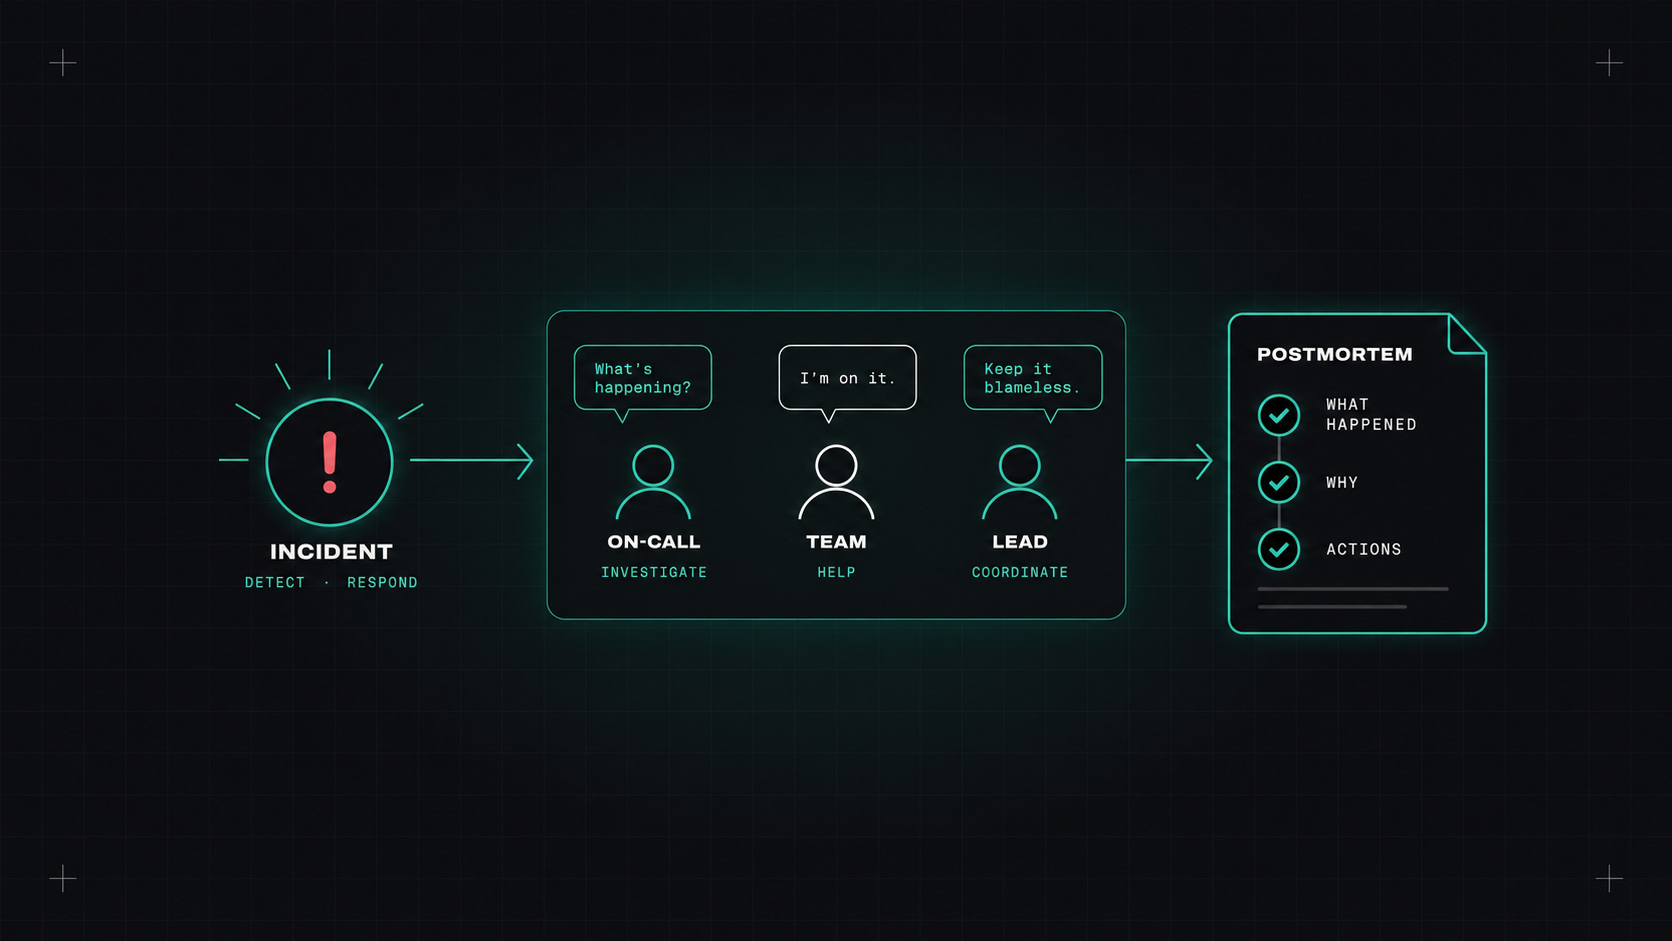
Jedes System bricht irgendwann zusammen. Was gute Teams von schwierigen unterscheidet, ist nicht, ob sie Zwischenfälle haben. Es geht darum, wie sie damit umgehen: ruhig oder chaotisch, und ob sie danach etwas lernen oder einfach weitermachen und auf den nächsten warten.
Hier ist der Vorfallprozess, den ich bevorzuge, und wie man Postmortems schreibt, die tatsächlich Dinge verbessern.
Vorfälle sind stressig. Stress macht Menschen schlecht im Improvisieren. Entscheiden Sie sich also im Voraus für die Grundlagen:
Eine einfache Schweregradskala:
| Schwere | Bedeutung | Beispiel |
|---|---|---|
| Die | Große Auswirkungen auf viele Nutzer oder Kerngeschäft | Alle sind ausgegangen. |
| Die | Bedeutende Auswirkungen, eine Umgehungsmethode oder ein teilweiser Ausfall | Zahlungsunfähigkeit für einen Anbieter |
| Die | Leichte Auswirkungen, begrenzte Nutzer | Ein nicht kritisches Merkmal ist kaputt. |
Wenn Sie Zweifel haben, sagen Sie höher. Es ist leicht zu degradieren.
Die wichtigste Rolle ist die Vorfallkommandant (IC)- Ich weiß . Die IC löst das Problem nicht. Sie koordinieren: stellen sicher, dass die richtigen Leute involviert sind, Entscheidungen getroffen werden und nichts durch die Risse fällt.
Weitere gemeinsame Aufgaben:
In einem kleinen Team kann eine Person mehrere Rollen übernehmen. Das ist in Ordnung, solange jemand klar verantwortlich ist.
In einem Zwischenfall ist die gefährlichste Situation, wenn fünf kluge Leute alles gleichzeitig reparieren, ohne dass jemand weiß, was die anderen geändert haben.
Ein paar Gewohnheiten, die einen großen Unterschied machen:
Eine einfache Status-Aktualisierungsvorlage:
[SEV2] Zahlungsunfähigkeit, Untersuchung. Seit 14:05 Uhr MEZ scheitern rund 10% der Kartenzahlungen. Andere Zahlungsmethoden funktionieren. Wir untersuchen ein mögliches Problem mit unserem Zahlungsanbieter. Nächstes Update um 14:45.
Eine Leichenuntersuchung ist eine schriftliche Analyse dessen, was passiert ist und wie man es verhindern kann. Unschuldig Das bedeutet, dass der Fokus auf dem System liegt, nicht auf dem, der einen Fehler gemacht hat.
Warum schuldlos? Weil Menschen ständig Fehler machen, und Systeme sollten dafür entwickelt werden. Wenn man sich aus einem Vorfall auskennt: "Alex hätte vorsichtiger sein sollen", ändert sich nichts, außer dass die Leute ihre Fehler verstecken. Wenn der Takeaway lautet: "Unser Bereitstellungsvorgang lässt eine nicht getestete Konfiguration ohne Überprüfung in die Produktion gelangen", können Sie den Prozess beheben.
Fragen zu stellen:
Das häufigste Versagen bei Postmortems: tolle Analyse, eine Liste von Aktionspunkten, und dann passiert nichts. Die Fixes konkurrieren mit den Feature-Arbeiten und verlieren.
Was hilft:
Incident.io, Rootly, FireHydrant, PagerDuty, Jira Service Management und andere automatisieren den Prozess: Erstellen von Kanälen, Zuordnung von Rollen, Zeitplanung, Posting von Statusaktualisierungen und Erstellung von Postmortem-Entwürfen. Nützlich, aber Prozess und Kultur sind wichtiger als Werkzeug.
Einig auf drei Schweregrads, die Rolle des Vorfallkommandanten, und eine Postmortem-Vorlage. Führen Sie einen kurzen Übungsinzident ("Spieltag") durch, damit die Leute den Prozess vor einem echten kennen. Dann, nach dem nächsten echten Vorfall, schreiben Sie eine schuldlose Obduktion und folgen Sie seinen Handlungen.
Meine Meinung: Unfälle werden passieren. Handeln Sie mit ihnen ruhig um, lernen Sie ehrlich daraus und beheben Sie das System, anstatt die Person zu beschuldigen.
Desly